Taak voor gegevensmodelversnelling wordt niet uitgevoerd
toepasbaarheid
Splunk Enterprise Splunk Cloudonderzoek
Stap 1: Bepaal hoeveel zoekresultaten voor gegevensmodelversnelling op die zoekkop worden uitgevoerd.
(Dit kan de mogelijke oorzaak elimineren dat het probleem te wijten is aan te veel DM-banen of niet)
index=_audit DM_* total_run_time=* | timechart max(total_run_time) as maxtime by savedsearch_name limit=20
Een voorbeeld van een gezond systeem met een totale acceleratie van 7 DM loopt.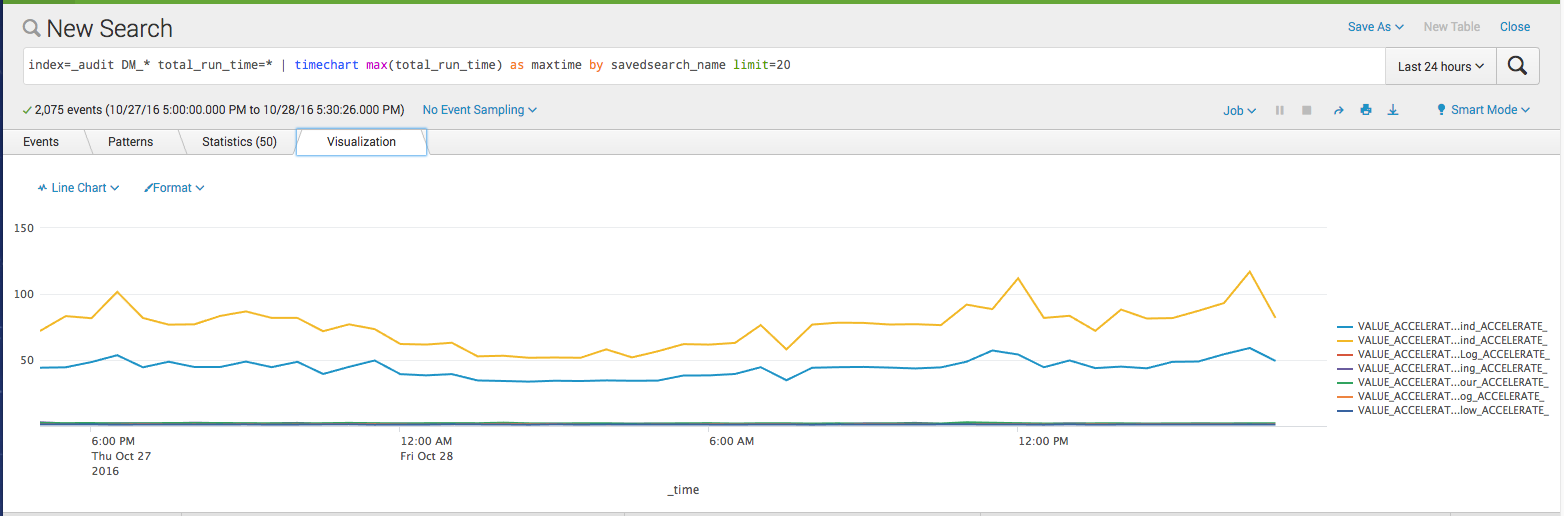
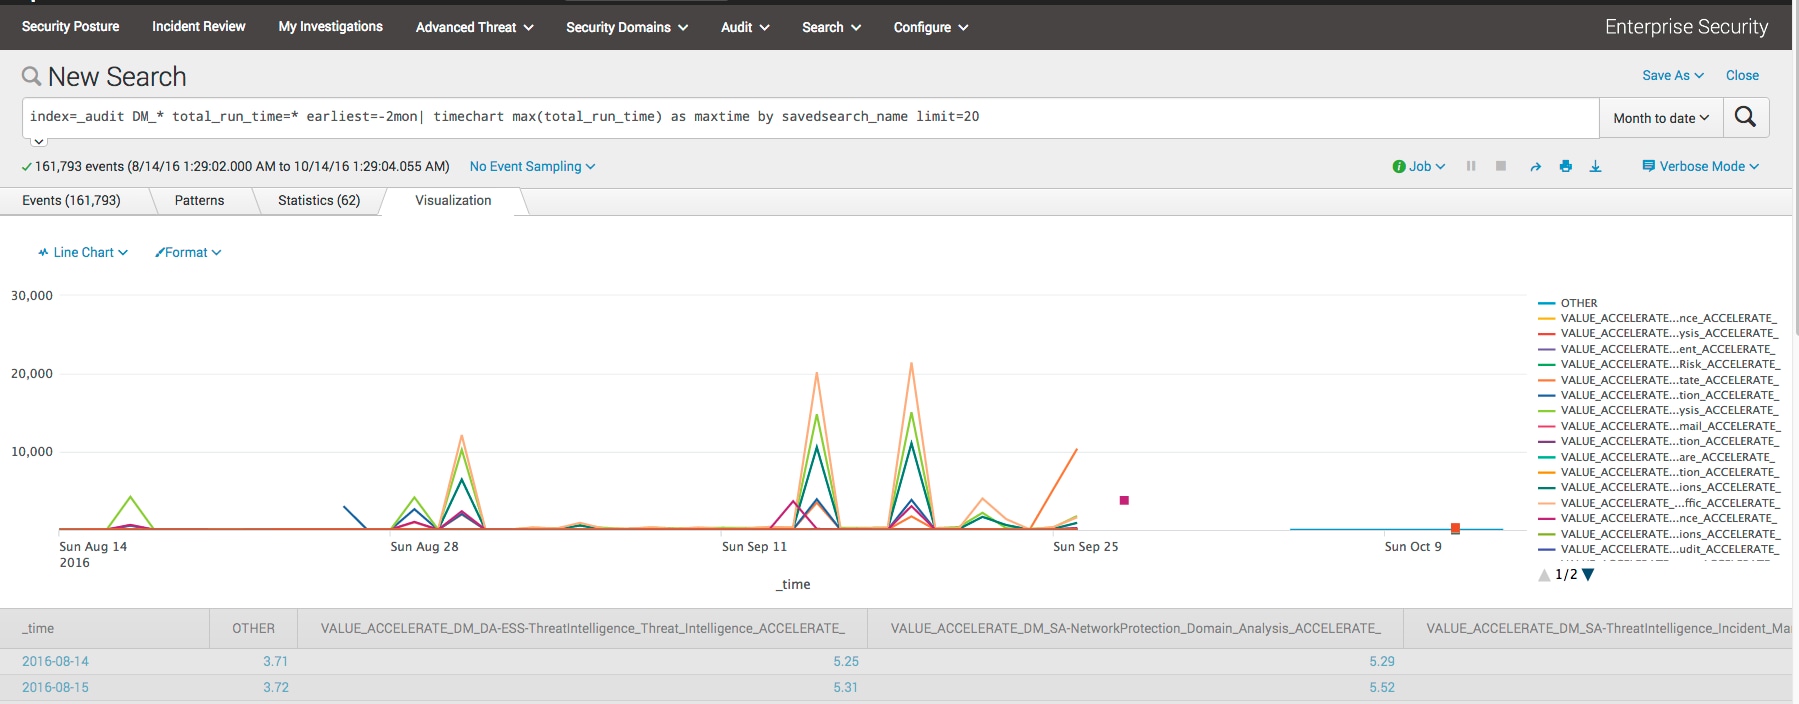
Onderstaande grafiek laat zien dat DM-zoeken meestal niet kan worden uitgevoerd en dit wijst op een probleem.
(Onderstaande grafiek laat zien dat het meer dan 20 DM versnelling heeft lopen.)
Stap 2: Selecteer een van de probleemversnellingstaken voor DM en controleer het aantal draaiende taken.
index=_audit DM_* total_run_time=* savedsearch_name=_ACCELERATE_DM_data_model_replacement_dm_ss_ind_ACCELERATE_|timechart count
Hieronder ziet u een gezonde Data Model-versnellingstaak die ongeveer 6 keer per uur loopt.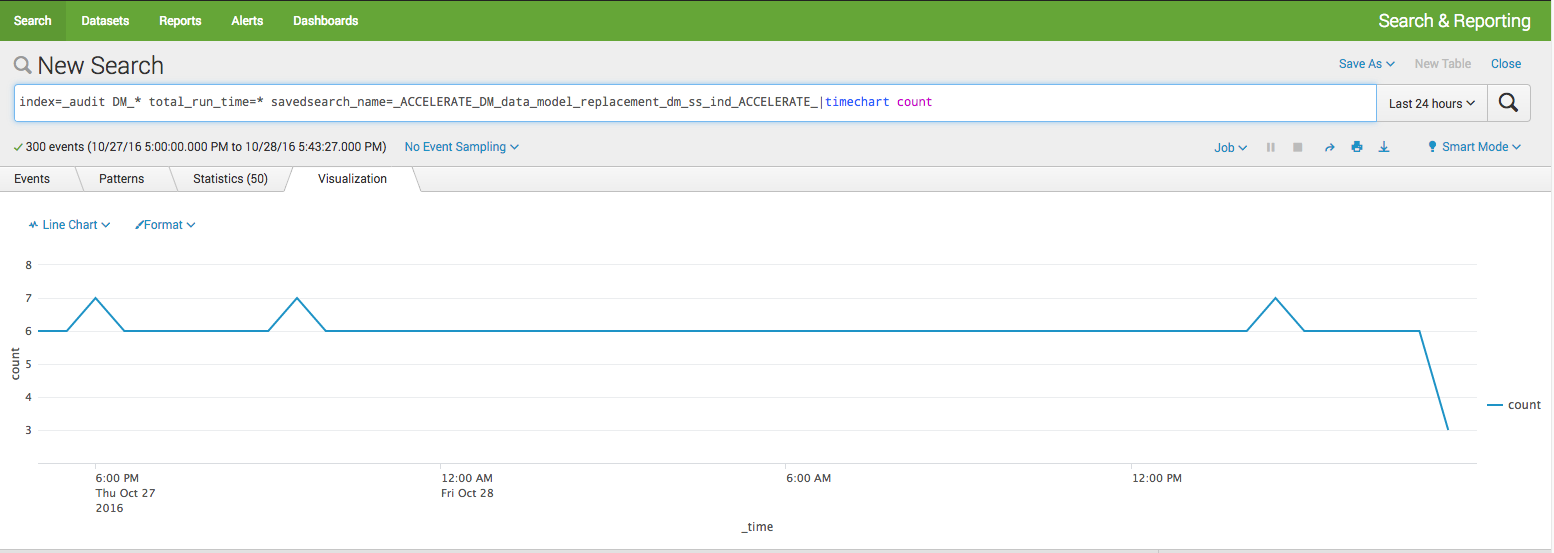
Onderstaande grafiek laat zien dat de DM-versnelling in de loop van de tijd tot nul is gedaald, wat wijst op een probleem.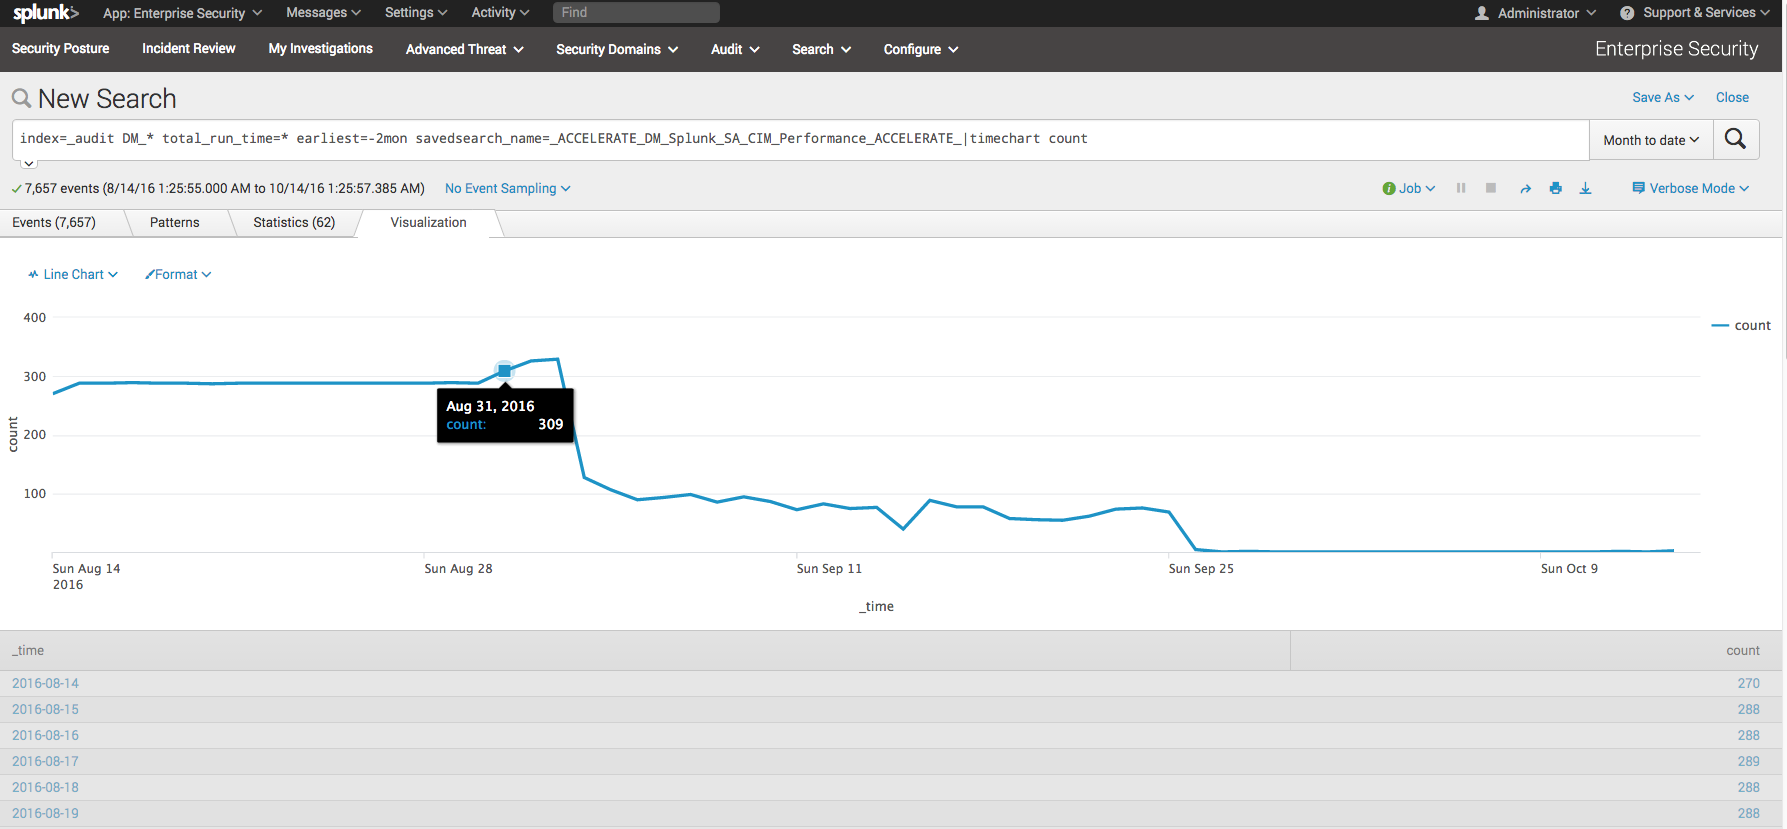
Stap 3: Controleer de scheduler.log, die u zal vertellen waarom de versnellingstaak voor het gegevensmodel niet wordt uitgevoerd.
index=_internal source=*scheduler.log savedsearch_id="*_ACCELERATE_DM_data_model_replacement_dm_ss_ind_ACCELERATE_*" |timechart count by reason
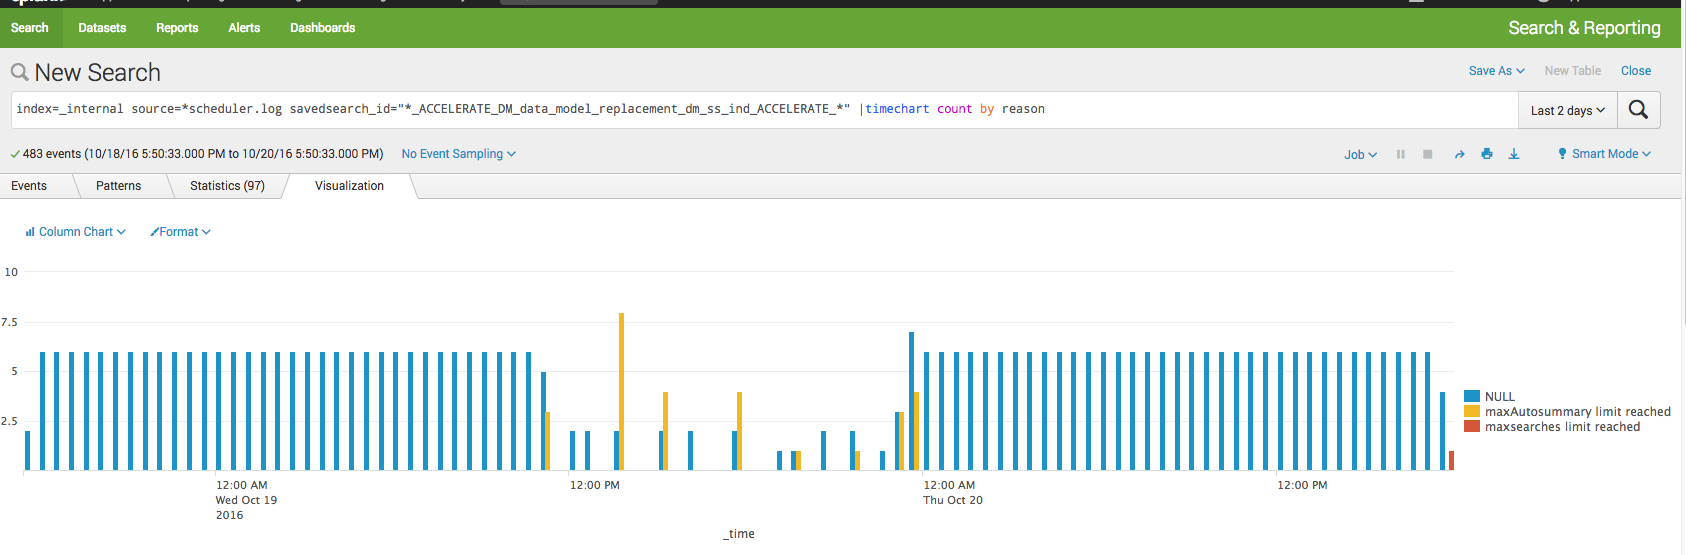
resolutie
Op basis van de reden die wordt teruggegeven van bovenstaande onderzoeksstap 3, moet u mogelijk de onderstaande configuratie afstemmen.limits.conf [search] base_max_searches = 6 max_searches_per_cpu = 1 max_rt_search_multiplier = 1[scheduler] max_searches_perc = 50 auto_summary_perc = 50
Revisiegeschiedenis
| Revisie | Publicatiedatum | Opmerkingen |
|---|---|---|
1.0 |
28-Sep-2026
|
Eerste vrijgave |
 Feedback
Contact Cisco
- Een ondersteuningscase openen

- (Vereist een Cisco-servicecontract)