La tâche d'accélération du modèle de données n'est pas exécutée
Applicabilité
Cloud Splunk Enterprise SplunkEnquête
Étape 1 :Déterminez le nombre de recherches d'accélération de modèle de données exécutées sur cette tête de recherche.
(Cela peut éliminer la cause possible que le problème soit dû à un trop grand nombre d'emplois DM ou non)
index=_audit DM_* total_run_time=* | timechart max(total_run_time) as maxtime by savedsearch_name limit=20
Un échantillon d'un système sain avec un total de 7 DM d'accélération est en cours d'exécution.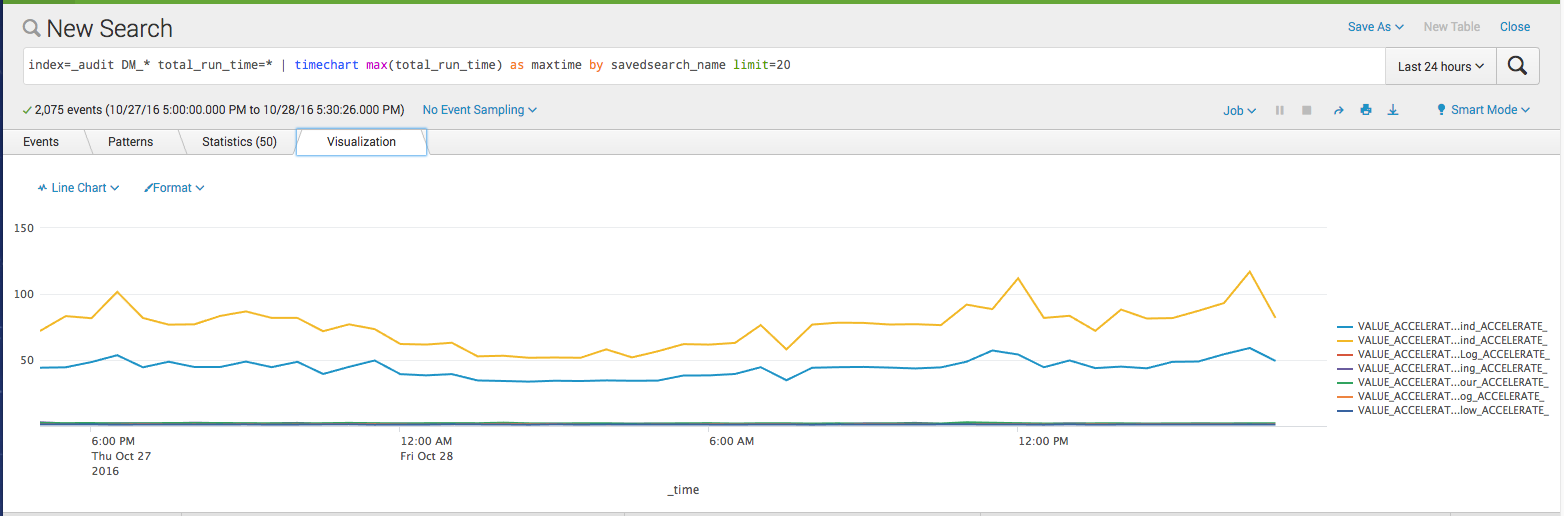
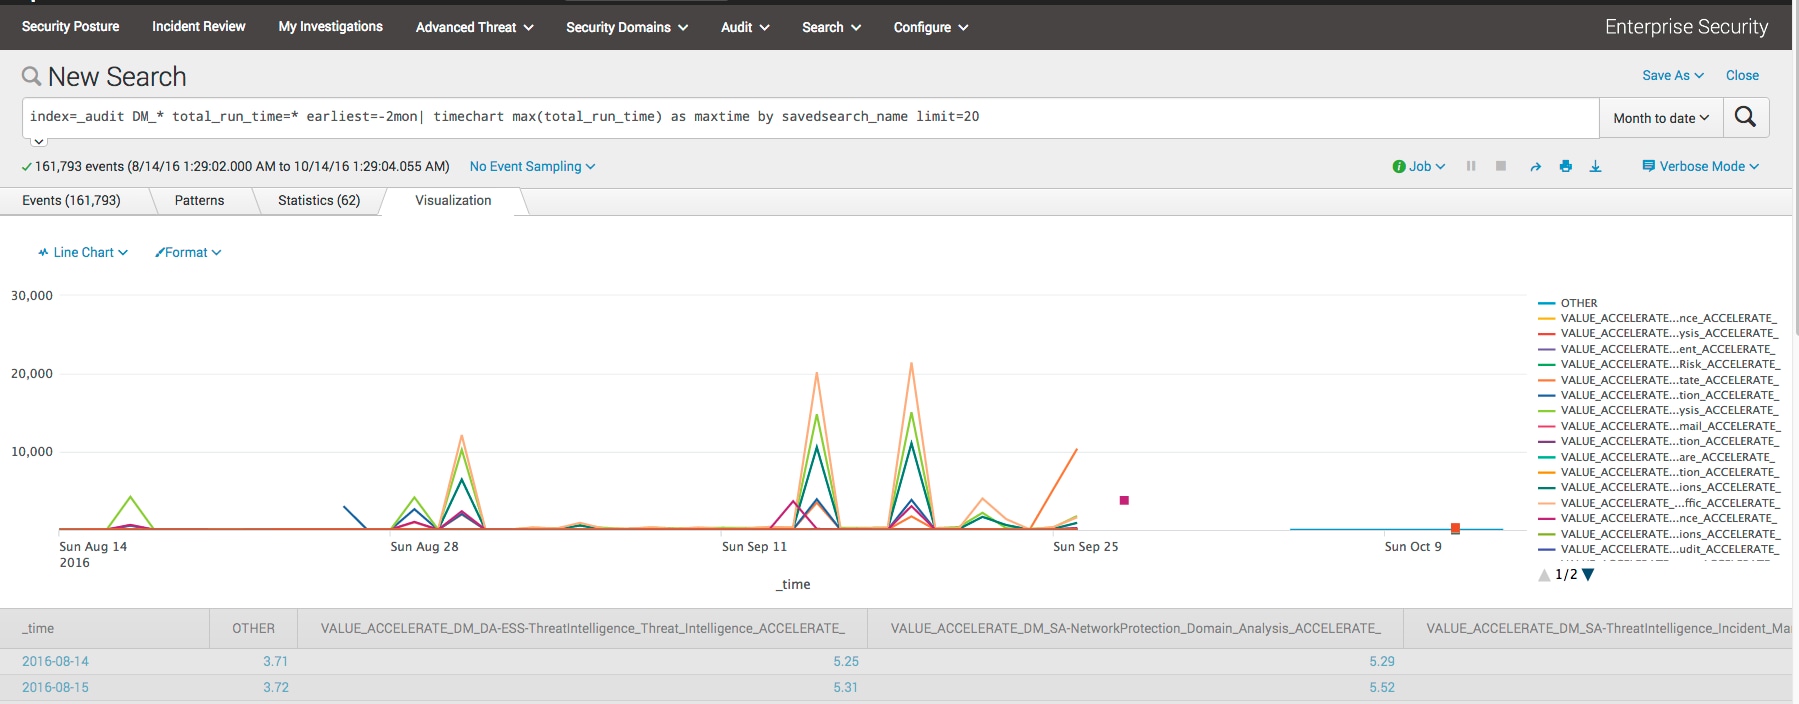
Le graphique ci-dessous montre que la recherche DM ne peut pas s'exécuter la plupart du temps, ce qui indique un problème.
(Le graphique ci-dessous montre que l'accélération est supérieure à 20 DM.)
Étape 2: Sélectionnez l'une des tâches d'accélération DM problématiques et vérifiez le nombre de tâches en cours.
index=_audit DM_* total_run_time=* savedsearch_name=_ACCELERATE_DM_data_model_replacement_dm_ss_ind_ACCELERATE_|timechart count
Ci-dessous figure un travail d'accélération de modèle de données sain qui s'exécute environ 6 fois par heure.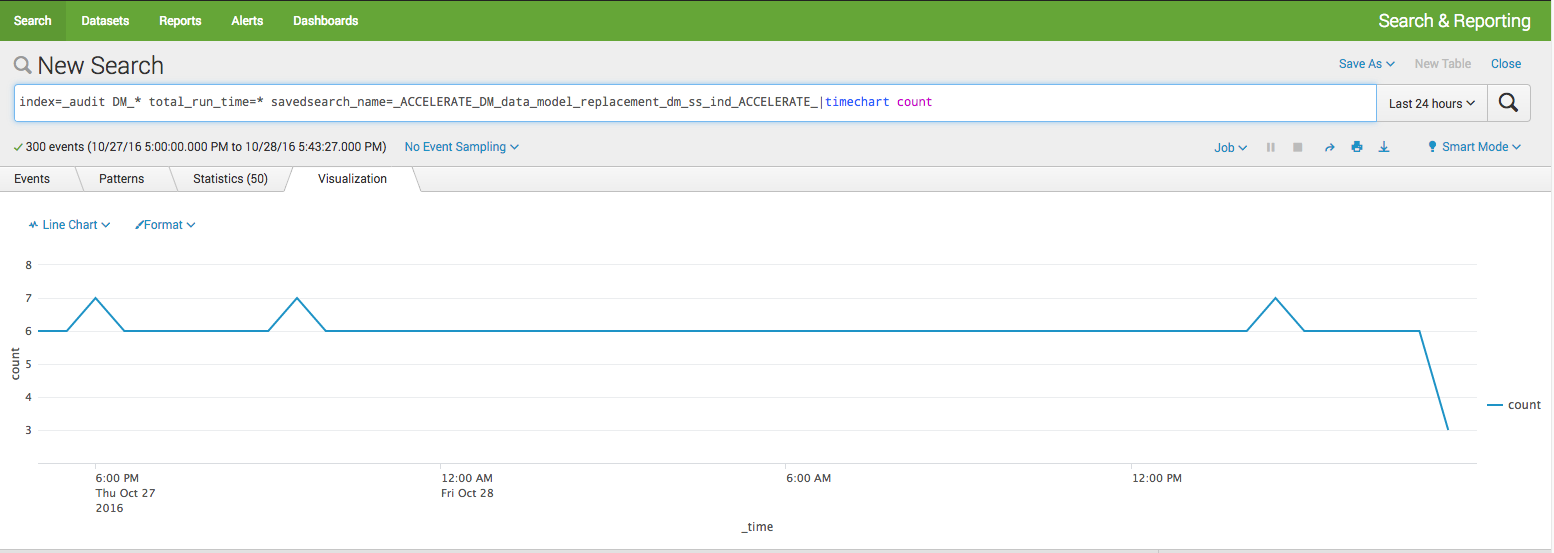
Le graphique ci-dessous montre que l'accélération DM est tombée à zéro au fil du temps, ce qui indique un problème.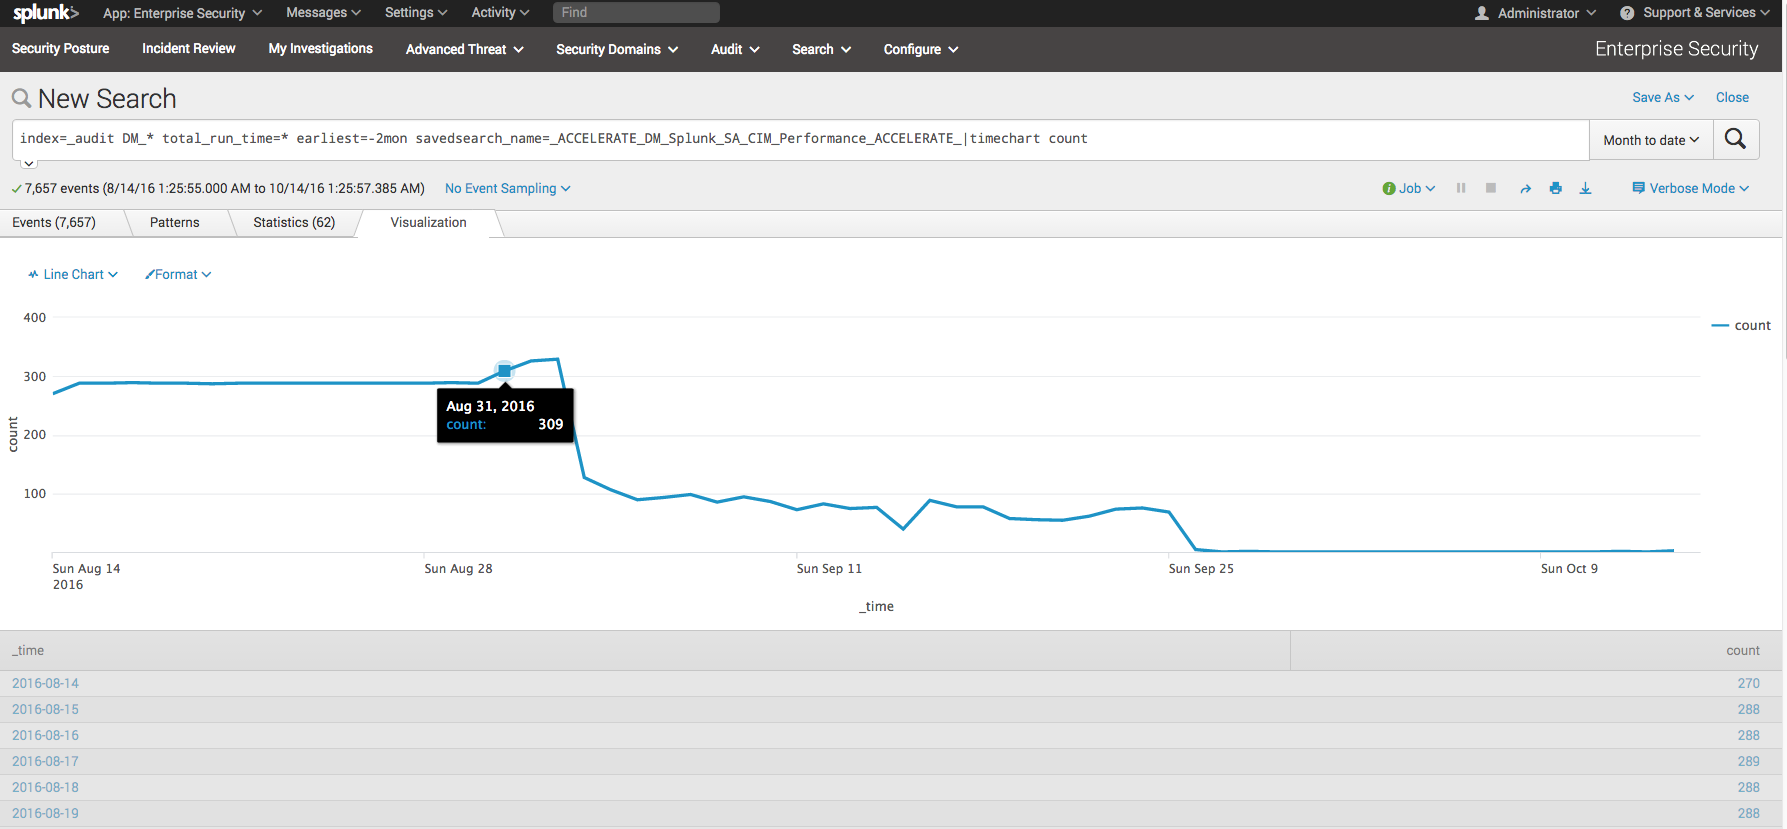
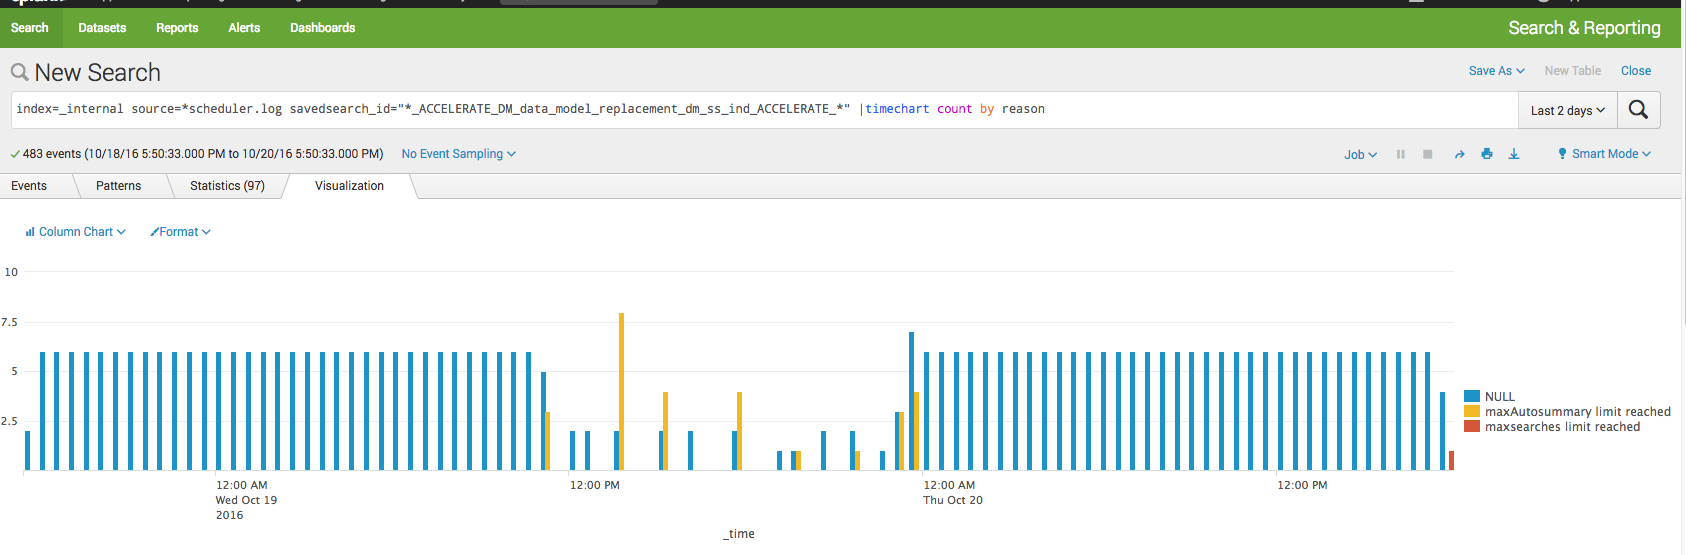
Étape 3: Consultez le fichier scheduler.log pour savoir pourquoi la tâche d'accélération du modèle de données n'est pas en cours d'exécution.
index=_internal source=*scheduler.log savedsearch_id="*_ACCELERATE_DM_data_model_replacement_dm_ss_ind_ACCELERATE_*" |timechart count by reason
Résolution
En fonction de la raison renvoyée par l'étape 3 de l'investigation ci-dessus, il peut être nécessaire d'ajuster la configuration ci-dessous.limits.conf [search] base_max_searches = 6 max_searches_per_cpu = 1 max_rt_search_multiplier = 1[scheduler] max_searches_perc = 50 auto_summary_perc = 50
Historique de révision
| Révision | Date de publication | Commentaires |
|---|---|---|
1.0 |
28-Sep-2026
|
Première publication |
 Commentaires
Contacter Cisco
- Ouvrir un dossier d’assistance

- (Un contrat de service de Cisco est requis)