ASR 1000 シリーズ ルータ上の高い CPU 使用率のトラブルシューティング

ダウンロード オプション
偏向のない言語
この製品のドキュメントセットは、偏向のない言語を使用するように配慮されています。このドキュメントセットでの偏向のない言語とは、年齢、障害、性別、人種的アイデンティティ、民族的アイデンティティ、性的指向、社会経済的地位、およびインターセクショナリティに基づく差別を意味しない言語として定義されています。製品ソフトウェアのユーザインターフェイスにハードコードされている言語、RFP のドキュメントに基づいて使用されている言語、または参照されているサードパーティ製品で使用されている言語によりドキュメントに例外が存在する場合があります。シスコのインクルーシブ ランゲージの取り組みの詳細は、こちらをご覧ください。
翻訳について
シスコは世界中のユーザにそれぞれの言語でサポート コンテンツを提供するために、機械と人による翻訳を組み合わせて、本ドキュメントを翻訳しています。ただし、最高度の機械翻訳であっても、専門家による翻訳のような正確性は確保されません。シスコは、これら翻訳の正確性について法的責任を負いません。原典である英語版(リンクからアクセス可能)もあわせて参照することを推奨します。
内容
概要
このドキュメントでは、ASR1000 シリーズ ルータでの CPU の高使用率の問題をトラブルシューティングする方法について説明します。
前提条件
要件
このドキュメントの解釈と利用をする際には、ASR1000のアーキテクチャを理解しておくことを推奨します。
説明
Ciscoルータで「CPUの使用率が高い」という状態は、ルータのCPU使用率が通常の使用率を超えている状態を指すと定義できます。一部のシナリオで CPU の使用率の増加があらかじめ予想されていても、別のシナリオでは同様の増加が問題と見なされる場合があります。ネットワーク変更や設定変更によってルータのCPU使用率が一時的に高くなることは無視でき、これは正常な動作です。
ただし、ネットワークや設定を変更することなく、長期間にわたってCPUの使用率が高いルータは異常であり、分析する必要があります。 そのため、使用率が高くなると、CPUは他のすべてのプロセスにアクティブにサービスを提供することができず、その結果、コマンドラインの処理速度が遅くなり、コントロールプレーンの遅延、パケットのドロップ、およびサービスの障害が発生します。
CPU の高使用率の理由として以下が考えられます。
- コントロールプレーンCPUが大量のパントトラフィックを受信する
- 予期しない動作を行い、CPUの過剰使用を引き起こすプロセス
- データプレーンプロセッサの使用率が高すぎる/加入過多
- プロセッサの割り込みが多発する
ルータのCPU使用率はルータの負荷に正比例するため、ASR1000シリーズルータでCPUの使用率が高くなる問題は必ずしも発生しません。 たとえば、ネットワークが変更されると、ネットワークが再収束するため、コントロールプレーントラフィックが大量に発生します。したがって、CPUの過剰使用の根本原因を特定して、それが予想される動作か問題かを判断する必要があります。
次の図は、CPU高使用率の問題をトラブルシューティングする方法を手順ごとに詳しく説明したものです。
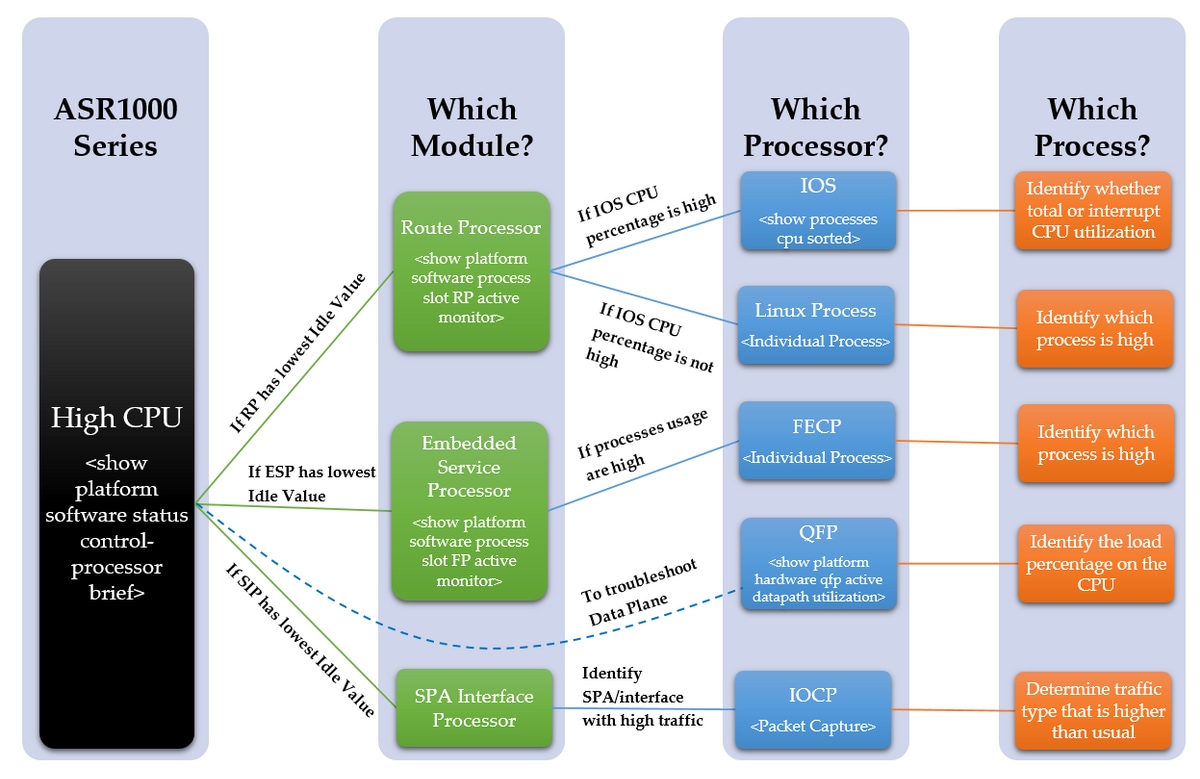
トラブルシューティングの手順
手順 1:CPU の使用率が高いモジュールの特定
ASR1000には、異なるモジュール間に複数の異なるCPUがあります。そのため、どのモジュールで、通常より使用率が高くなっているかを確認する必要があります。これはIdle値から確認できます。アイドル値が低いほど、そのモジュールのCPU使用率が高くなります。これらの異なるCPUはすべて、モジュールのコントロールプレーンを反映しています。
デバイス内のどのモジュールでCPUの使用率が高くなることが確認されているかを判別します。次のコマンドを使用して、それが RP、ESP、SIP のいずれであるかを判断します。
show platform software status control-processor brief
強調表示されている列を確認するには、次の出力を参照してください
RP のアイドル値が低くなっている場合、手順 2 のポイント 1 に進みます。
ESP のアイドル値が低くなっている場合、手順 3 のポイント 2 に進みます。
SIP のアイドル値が低くなっている場合、手順 4 のポイント 3 に進みます。
Router#show platform software status control-processor brief
Load Average
Slot Status 1-Min 5-Min 15-Min
RP0正常0.00 0.02 0.00
ESP0正常0.01 0.02 0.00
SIP0正常0.00 0.01 0.00
Memory (kB)
Slot Status Total Used (Pct) Free (Pct) Committed (Pct)
RP0正常2009376 1879196 (94%) 130180 ( 6%) 1432748 (71%)
ESP0正常2009400 692100 (34%) 1317300 (66%) 472536 (24%)
SIP0 Healthy 471804 284424 (60%) 187380 (40%) 193148 (41%)
CPU Utilization
Slot CPU User System Nice Idle IRQ SIRQ IOwait
RP0 0 2.59 2.49 0.00 94.80 0.00 0.09 0.00
ESP0 0 2.30 17.90 0.00 79.80 0.00 0.00 0.00
SIP0 0 1.29 4.19 0.00 94.41 0.09 0.00 0.00
アイドル値がすべて比較的高ければ、コントロール プレーンの問題ではないと思われます。データ プレーンをトラブルシューティングするには、ESP の QFP を監視する必要があります。「高CPU」の症状は、コントロールプレーンプロセッサのCPU使用率が高くなることのないQFPの過剰使用によって引き続き発生する可能性があります。手順 6 に進んでください。
手順 2:モジュールの分析
- ルート プロセッサ
次のコマンドを使用して、どのプロセッサのCPU使用率が高くなっていることがRP内で確認できます。Linux プロセスでしょうか。それとも IOS でしょうか。
show platform software process slot RP active monitor
IOS CPU のパーセンテージが高くなっている場合(linux_iosd-imag)、問題は RP IOS にあります。手順 3 に進んでください。
他のプロセスのCPUパーセンテージが高い場合は、Linuxプロセスである可能性があります。手順 4 に進んでください。
- エンベデッド サービス プロセッサ
コントロールプレーンプロセッサのCPU使用率が高いことが確認された場合は、ESP内で確認します。それは FECP でしょうか。
show platform software process slot FP active monitor
プロセスの使用率が高くなっていれば、FECP に問題があります。ステップ 5 に進んでください。
FECPでない場合は、ESP内のコントロールプレーンプロセスに関連する問題ではありません。ネットワーク遅延やキューのドロップなどの症状が引き続き発生する場合は、データプレーンで過剰使用を確認する必要があります。手順 6 に進んでください。
- SPA インターフェイス プロセッサ
SIPのCPU使用率が高い場合は、IOCPのCPU使用率が高くなっています。IOCP内のどのプロセスでCPU使用率が高くなることが確認されているかを判別します。
パケットキャプチャを実行し、どのトラフィックが通常よりも高く、どのプロセスがこのタイプのトラフィックに関連付けられているのかを特定します。 手順 7 に進んでください。
手順 3:IOS プロセス
次の出力を参照すると、最初のパーセンテージはCPUの総使用率で、2番目のパーセンテージは、パントされたパケットの処理に使用されるCPUの総量である割り込みCPUの使用率です。
割り込みのパーセンテージが高い場合は、大量のトラフィックがRPにパントされていることを示しています(これは、show platform software infrastructure puntコマンドで確認できます)
割り込みのパーセンテージが低いが、CPUの合計が高い場合は、CPUを長期間使用するプロセスが観察されます。
次のコマンドを使用して、どのプロセスでCPU使用率が高くなることが確認されているかをIOS内で確認します。
show processes cpu sorted
どのパーセンテージ(全体の CPU または割り込みの CPU)が高くなっているか特定し、必要に応じて個別のプロセスを識別します。手順 7 に進んでください。
Router#show processes cpu sorted
5秒間のCPU使用率:0%/0%、1分:1%、5分:1%
呼び出されたPIDランタイム(ミリ秒) 5秒1分5分TTYプロセス
呼び出されたPIDランタイム(ミリ秒) 5秒1分5分TTYプロセス
188 8143 434758 18 0.15% 0.18% 0.19% 0 Ethernet Msec Ti
515 380 7050 53 0.07% 0.00% 0.00% 0 SBCメインプロセス
3 2154 215 10018 0.07% 0.00% 0.19% 0 Exec
380 1783 55002 32 0.07% 0.06% 0.06% 0 MMA DBタイマー
63 3132 11143 281 0.07% 0.07% 0.07% 0 IOSD ipc task
5 1 2 500 0.00% 0.00% 0.00% 0 IPC ISSUディスパッチ
6 19 12 1583 0.00% 0.00% 0.00% 0 RFスレーブメインTh
8 0 1 0 0.00% 0.00% 0.00% 0 RO通知タイマー
7 0 1 0 0.00% 0.00% 0.00% 0 EDDRI_MAIN
10 6 75 80 0.00% 0.00% 0.00% 0プールマネージャ
9 5671 538 10540 0.00% 0.14% 0.12% 0 Check heaps
手順 4:Linux プロセス
IOSがCPUを過剰に使用していることが判明した場合は、個々のLinuxプロセスのCPU使用率を確認する必要があります。これらのプロセスは、show platform software process slot RP active monitorでリストされる他のプロセスです。どのプロセスでCPUの使用率が高くなることが確認されたのかを特定し、手順7に進みます。
手順 5:FECP プロセス
1つまたは複数のプロセスの使用率が高い場合、それらのプロセスがCPU高使用率の原因になっている可能性があります。手順7に進みます
手順6:QFP使用率
Quantum Flow Processor はフォワーディング ASIC です。フォワーディングエンジンの負荷を判別するために、QFPをモニタできます。以下のコマンドによって、pps および bps 単位で入出力パケット(優先および非優先)がリストされます。最終行には、パケット転送による CPU 負荷の合計量がパーセンテージで示されます。
show platform hardware qfp active datapath utilization
入力または出力が高いかどうかを確認し、プロセスの負荷を確認してから、手順7に進みます
Router#show platform hardware qfp active datapath utilization
CPP 0:サブデバイス0 5秒1分5分60分
入力:プライオリティ(pps) 0 0 0 0
(bps) 208 176 176 176
非優先度(pps) 0 2 2 2
(bps) 64 784 784 784
合計(pps) 0 2 2 2
(bps) 272 960 960 960
出力:プライオリティ(pps) 0 0 0 0
(bps) 192 160 160 160
非優先度(pps) 0 1 1 1
(bps) 0 6488 6496 6488
合計(pps) 0 1 1 1
(bps) 192 6648 6656 6648
処理中:ロード(pct) 0 0 0 0
手順 7:根本原因の特定と修正方法の識別
CPUの過剰使用が確認されたプロセスが特定されると、CPUの高使用が発生した理由がはっきりとわかります。続行するには、特定されたプロセスによって実行される機能を調査します。これは、問題へのアプローチ方法に関するアクションプランの決定に役立ちます。たとえば、プロセスが特定のプロトコルに関与している場合、そのプロトコルに関連する設定を確認することができます。
それでもCPU関連の問題が発生する場合は、TACに連絡して、エンジニアによるトラブルシューティングのサポートを受けることをお勧めします。上記のトラブルシューティング手順は、エンジニアがより効率的に問題を切り分けるのに役立ちます。
トラブルシューティングの例
この例では、トラブルシューティングのプロセスを実行し、ルータのCPU高使用率の根本原因の特定を試みます。まず、どのモジュールでCPUの使用率が高くなっていると判断するために、次の出力を用意しました。
Router#show platform software status control-processor brief
Load Average
Slot Status 1-Min 5-Min 15-Min
RP0正常0.66 0.15 0.05
ESP0正常0.00 0.00 0.00
SIP0正常0.00 0.00 0.00
Memory (kB)
Slot Status Total Used (Pct) Free (Pct) Committed (Pct)
RP0正常2009376 1879196 (94%) 130180 ( 6%) 1432756 (71%)
ESP0正常2009400 692472 (34%) 1316928 (66%) 472668 (24%)
SIP0 Healthy 471804 284556 (60%) 187248 (40%) 193148 (41%)
CPU Utilization
Slot CPU User System Nice Idle IRQ SIRQ IOwait
RP0 0 57.11 14.42 0.00 0.00 28.25 0.19 0.00
ESP0 0 2.10 17.91 0.00 79.97 0.00 0.00 0.00
SIP0 0 1.20 6.00 0.00 92.80 0.00 0.00 0.00
RP0内のIdleの量が非常に少ないため、ルートプロセッサ内でCPUの高使用率の問題が発生している可能性があります。したがって、さらにトラブルシューティングを行うために、RP内のどのプロセッサでCPUの使用率が高くなることが確認されたのかを特定します。
Router#show processes cpu sorted
5秒間のCPU使用率:84%/36%、1分:34%、5分:9%
呼び出されたPIDランタイム(ミリ秒) 5秒1分5分TTYプロセス
107 303230 50749 5975 46.69% 18.12% 4.45% 0 IOSXE-RP Punt Se
63 105617 540091 195 0.23% 0.10% 0.08% 0 IOSD ipc task
159 74792 2645991 28 0.15% 0.06% 0.06% 0 VRRSメインスレッド
116 53685 169683 316 0.15% 0.05% 0.01% 0 Per-Second Jobs
9 305547 26511 11525 0.15% 0.28% 0.16% 0 Check heaps
188 362507 20979154 17 0.15% 0.15% 0.19% 0 Ethernet Msec Ti
3 147 186 790 0.07% 0.08% 0.02% 0 Exec
2 32126 33935 946 0.07% 0.03% 0.00% 0 Load Meter
446 416 33932 12 0.07% 0.00% 0.00% 0 VDC process
164 59945 5261819 11 0.07% 0.04% 0.02% 0 IP ARP Retry Age
43 1703 16969 100 0.07% 0.00% 0.00% 0 IPCキープアライブM
この出力から、全体の CPU パーセンテージと割り込みのパーセンテージが予想されている量よりも多いことが分かります。CPUを利用するトッププロセスは、「IOSXE-RP Punt Se」です。これは、RP CPUのトラフィックを処理するプロセスです。したがって、RPにパントされたこのトラフィックをさらに詳しく調べることができます。
Router#show platform software infrastructure punt
LSMPI interface internal stats:
enabled=0, disabled=0, throttled=0, unthrottled=0, state is ready
Input Buffers = 90100722
Output Buffers = 100439
rxdone count = 90100722
txdone count = 100436
Rx no particletype count = 0
Tx no particletype count = 0
Txbuf from shadow count = 0
No start of packet = 0
No end of packet = 0
Punt drop stats:
Bad version 0
Bad type 0
Had feature header 0
Had platform header 0
Feature header missing 0
Common header mismatch 0
Bad total length 0
Bad packet length 0
Bad network offset 0
Not punt header 0
Unknown link type 0
No swidb 1
Bad ESS feature header 0
No ESS feature 0
No SSLVPN feature 0
Punt For Us type unknown 0
Punt cause out of range 0
IOSXE-RP Punt packet causes:
62210226レイヤ2制御パケットとレガシーパケット
147 ARP request or response packets
27801234 For-us data packets
84426 RP<->QFP keepalive packets
6 Glean adjacency packets
1647 For-us control packets
FOR_US Control IPv4 protcol stats:
1647 OSPF packets
Packet histogram(500 bytes/bin), avg size in 92, out 56:
Pak-Size In-Count Out-Count
0+: 90097805 98790
500+:0 7
この出力から、「For-us data packets」に大量のパケットがあることが分かります。これは、ルータに向かうトラフィックを示しており、このカウンタは、コマンドを数分間複数回観察した結果、増加していることが確認されています。これにより、大量のパントされたトラフィック(多くの場合、コントロールプレーントラフィック)によってCPUが過剰に使用されていることが確認できます。コントロールプレーントラフィックには、ARP、SSH、SNMP、ルートアップデート(BGP、EIGRP、OSPF)などが含まれます。この情報から、CPU高使用率の潜在的な原因を特定し、根本原因のトラブルシューティングに役立てることができます。たとえば、異なるトラフィックのパケットキャプチャまたはモニタを実装して、RPにパントされた正確なトラフィックを確認できます。これにより、根本原因を特定して解決し、将来の同様の問題を防止できます。
パケット キャプチャを完了すると、潜在的なパント トラフィックの例は、次のようになります。
- ARP:これは、複数のIPアドレスがブロードキャストインターフェイスへのIPルートの設定によってARP要求を送信する場合に発生する、過剰な数のARP要求が原因である可能性があります。これは、ARPテーブルからフラッシュされたエントリが原因である可能性もあり、エージングアウトするMACアドレスエントリまたはアップ/ダウンするインターフェイスに基づいて再学習する必要があります。
- SSH:これは、大きなshowコマンド(show tech-support)が原因で、または多数のdebugコマンドが有効になっていて、大量のCLIがSSHセッションを介して送信される場合に、CPUの高使用を引き起こす可能性があります。
- SNMP:これは、SNMPエージェントが要求の処理に長時間を要するため、CPUの使用率が高くなることが原因である可能性があります。通常、2つの考えられる原因は、ポーリングされるMIB、またはNMSによってポーリングされるルートテーブルやARPテーブルです。
- ルートアップデート:ルートアップデートの流入は、ネットワークの再コンバージェンス(リンクのフラップ)が原因で発生することがよくあります。これは、ネットワーク内でダウンするルートや、ダウンするデバイス全体を示している可能性があります。デバイス全体がダウンすると、ネットワークが収束し、使用されているルーティングプロトコルに応じて最適なルートが再計算されます。
これは、個々のプロセスレベルに至った場合に、高いCPU使用率の原因を特定することで、根本原因を特定する方法を示しています。ここから、発生している状況が設定の問題であるか、ソフトウェアの問題であるか、またはネットワーク設計に起因しているか、それとも意図された動作であるかを識別するために、個々のプロセスまたはプロトコルを切り離して分析することができます。
追加コマンド
次に、使用する他の便利なコマンドのリストを示します。関連するプロセッサによってソートされています。
ルート プロセッサ
- <show process cpu history>
- 過去 60 秒、分、72 時間の CPU の履歴をグラフで示します。
- <show process process_ID>
- 個々のプロセスに割り当てられているメモリおよび CPU の詳細を示します。
- <show platform software infrastructure punt>
- RPにパントされるすべてのトラフィックに関する情報を提供する
- <show platform software status control-processor brief>
- メモリとモジュールの統計情報とともに CPU の負荷と「健全性」を示します。
- <show platform software process slot r0|r1 monitor>
- 選択したモジュールのプロセスおよびそれらの CPU とメモリの割り当てに関する詳細を示します。
- <monitor platform software process r0|r1>
- CPUを使用するプロセスの更新をライブフィードで提供
- 正常に機能するように、最初にグローバル コンフィギュレーション モードでコマンド「terminal terminal-type」を入力する必要があります。
エンベデッド サービス プロセッサ
- <show platform software process list fp active summary>
- CPUで実行されているすべてのプロセスの概要と平均負荷を示します。
- <show platform software process slot f0|f1 monitor>
- 選択したモジュールのプロセスおよびそれらの CPU とメモリの割り当てに関する詳細を示します。
- <monitor platform software process f0|f1>
- CPUを利用するプロセスを更新するライブフィードを提供します。
- 正常に機能するように、最初にグローバル コンフィギュレーション モードでコマンド「terminal terminal-type」を入力する必要があります。
 フィードバック
