Il processo di accelerazione del modello di dati non è in esecuzione
Applicabilità
Splunk Enterprise Splunk CloudIndagine
Passaggio 1: determinare il numero di ricerche di accelerazione del modello di dati in esecuzione su tale testina di ricerca.
(in questo modo si può eliminare la possibile causa del problema che è dovuto o meno a troppi lavori DM)
index=_audit DM_* total_run_time=* | timechart max(total_run_time) as maxtime by savedsearch_name limit=20
È in esecuzione un esempio di un sistema integro con un'accelerazione totale di 7 DM.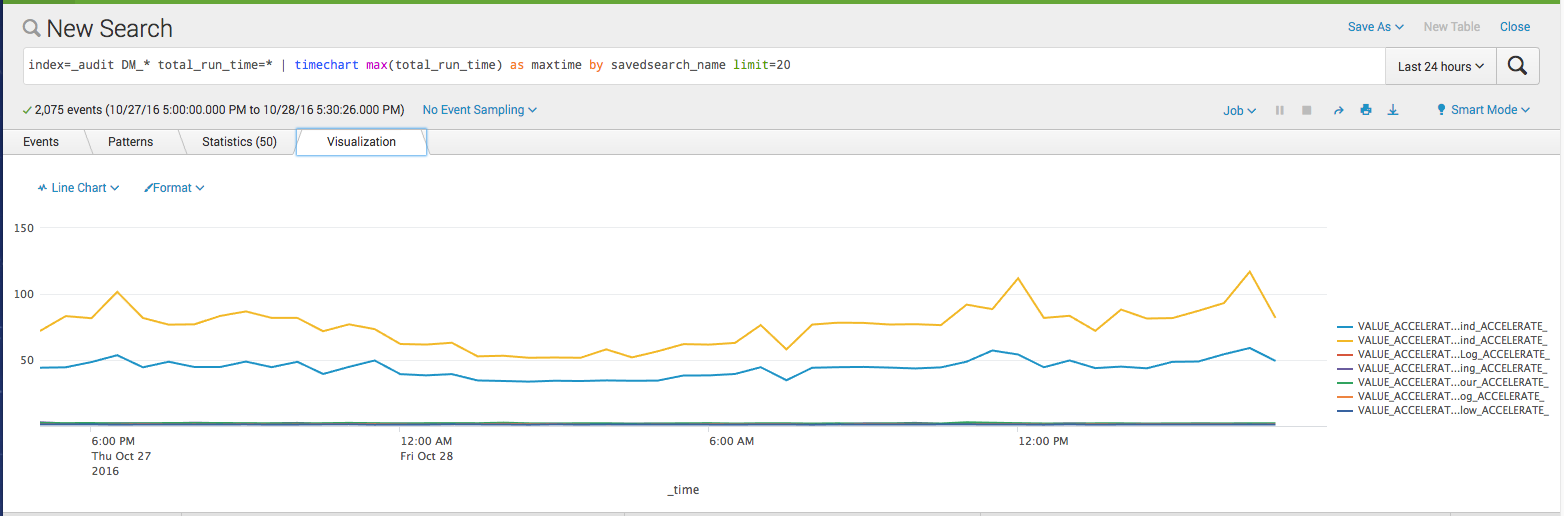
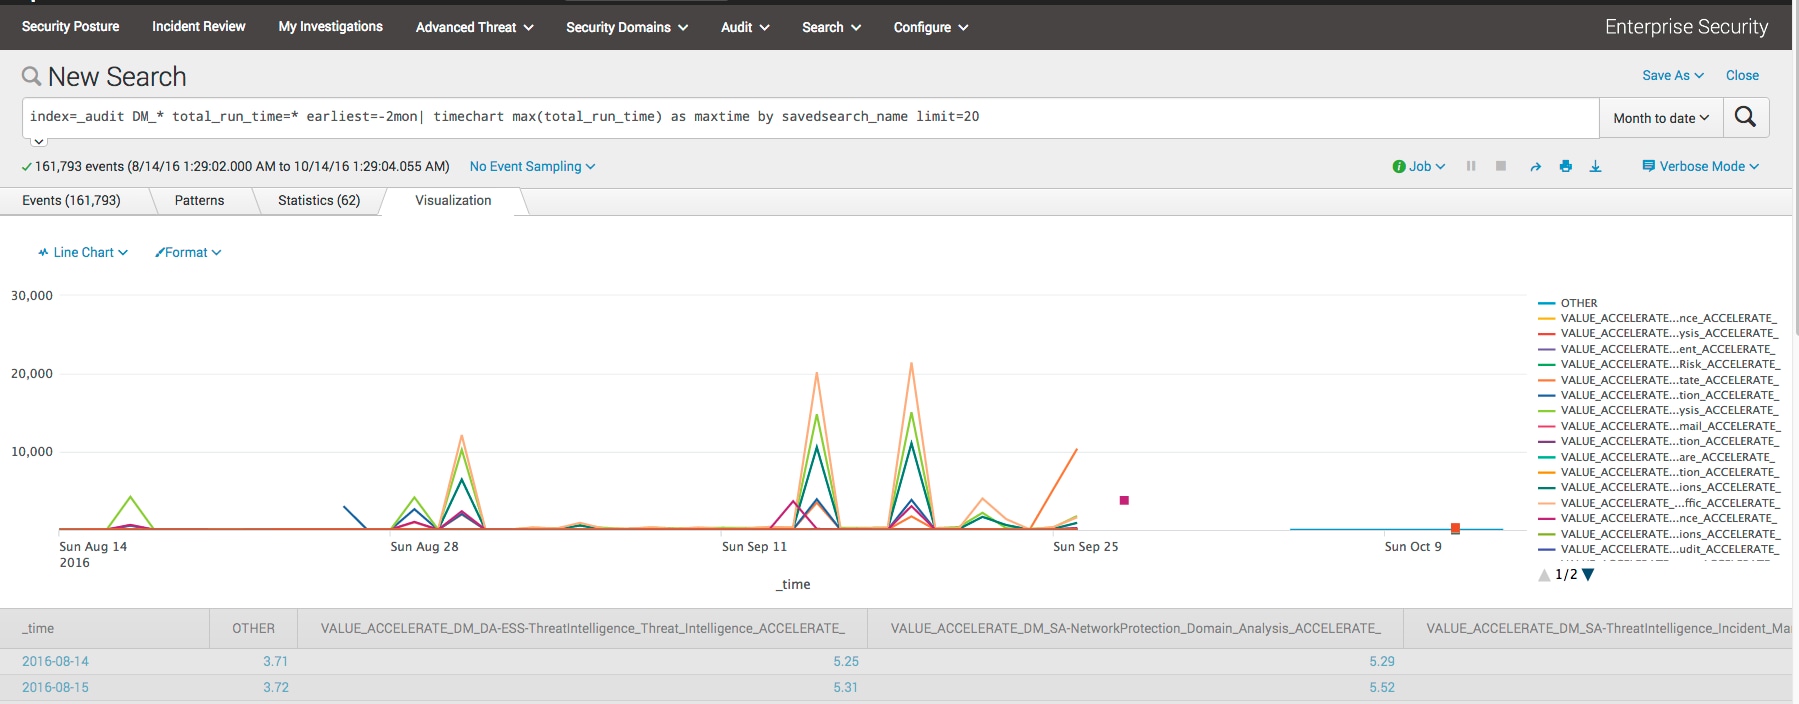
Il grafico seguente mostra che DM Search non può essere eseguito per la maggior parte del tempo e questo indica un problema.
(Il grafico sottostante mostra che l'accelerazione DM è in esecuzione.)
Passaggio 2: Selezionare uno dei job di accelerazione DM con problemi e controllare il conteggio corrente.
index=_audit DM_* total_run_time=* savedsearch_name=_ACCELERATE_DM_data_model_replacement_dm_ss_ind_ACCELERATE_|timechart count
Di seguito viene illustrato un processo di accelerazione del modello di dati integro che viene eseguito circa 6 volte all'ora.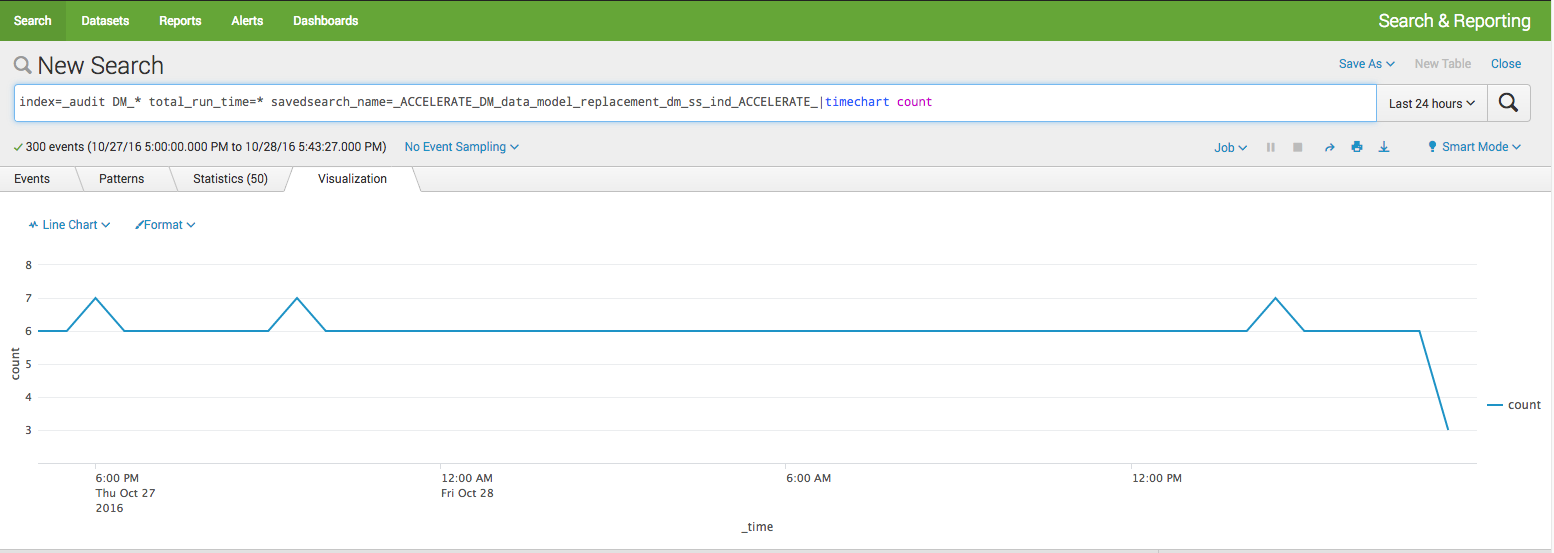
Il grafico seguente mostra che l'accelerazione DM è scesa a zero nel tempo, il che indica un problema.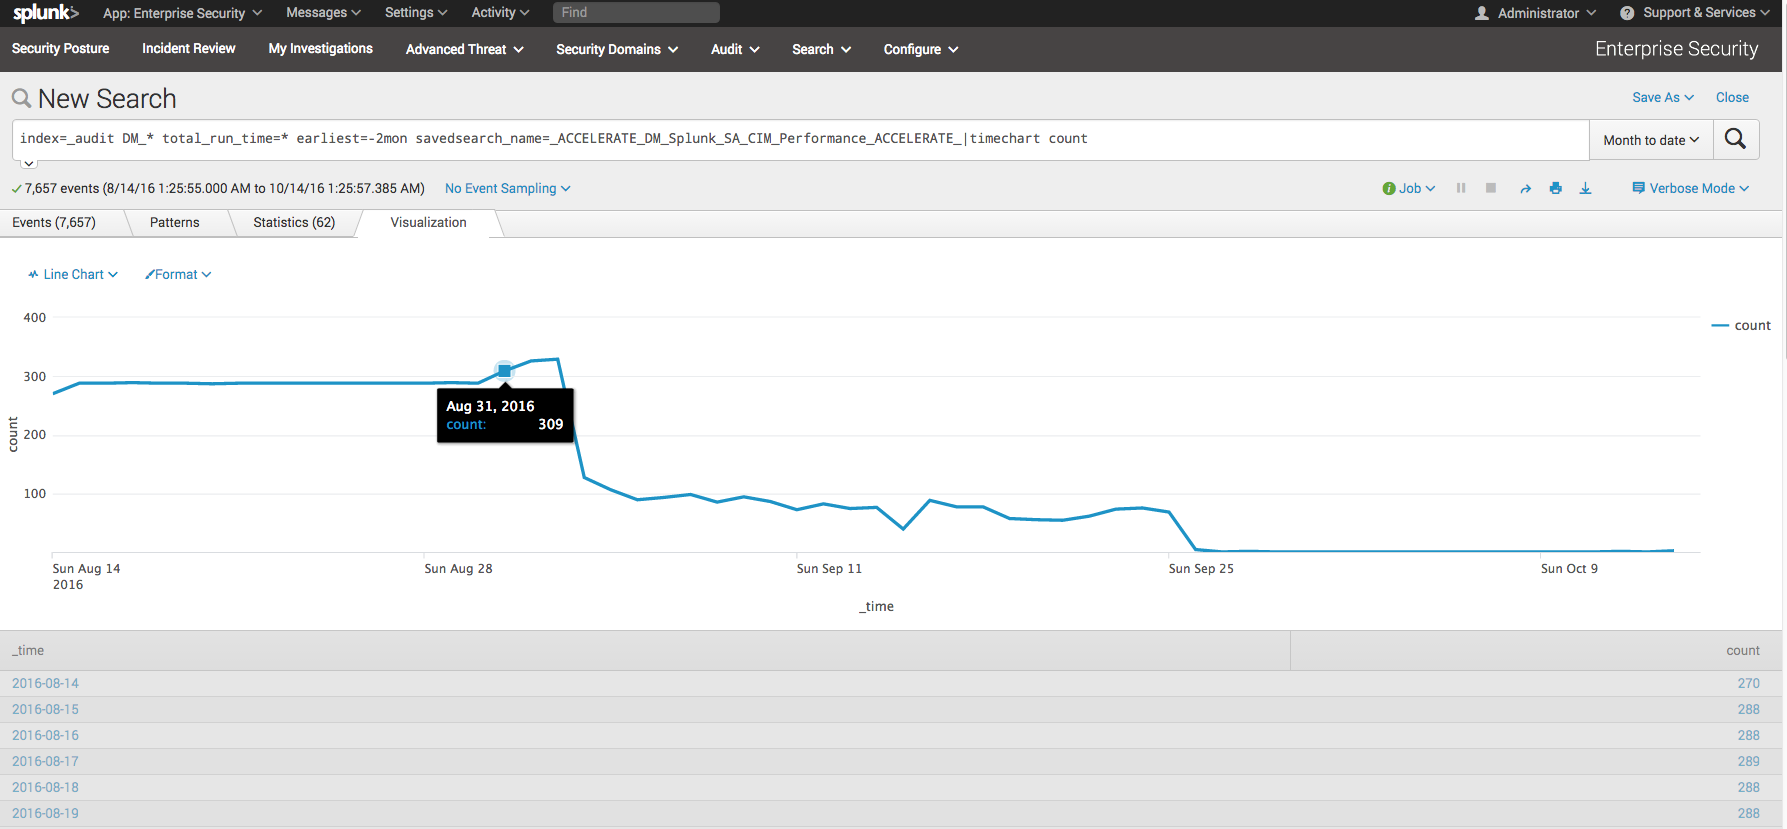
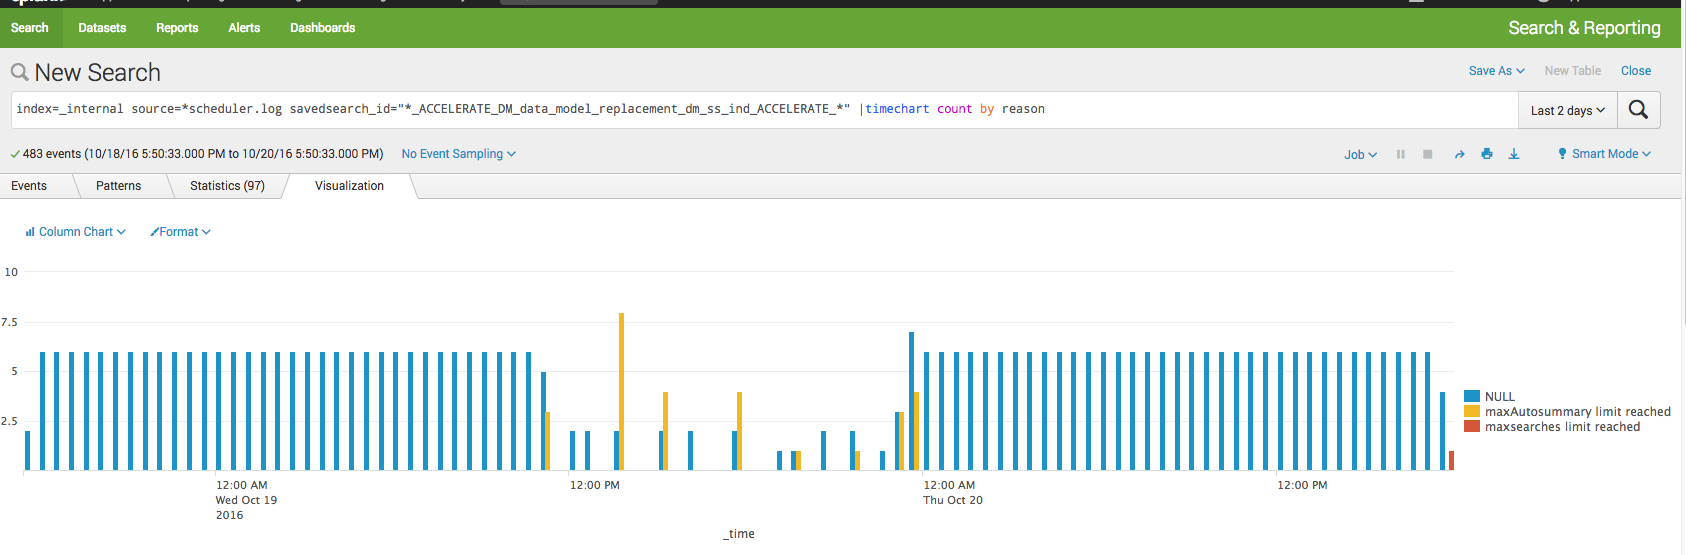
Passaggio 3: Controllare il file scheduler.log che indicherà il motivo per cui il processo di accelerazione del modello dati non è in esecuzione.
index=_internal source=*scheduler.log savedsearch_id="*_ACCELERATE_DM_data_model_replacement_dm_ss_ind_ACCELERATE_*" |timechart count by reason
Risoluzione
In base al motivo restituito dal passaggio di analisi precedente 3, potrebbe essere necessario sintonizzarsi sulla configurazione sottostante.limits.conf [search] base_max_searches = 6 max_searches_per_cpu = 1 max_rt_search_multiplier = 1[scheduler] max_searches_perc = 50 auto_summary_perc = 50
Cronologia delle revisioni
| Revisione | Data di pubblicazione | Commenti |
|---|---|---|
1.0 |
28-Sep-2026
|
Versione iniziale |
 Feedback
