Dépanner un CPU élevé sur le routeur de la gamme ASR1000

Options de téléchargement
-
ePub (465.7 KB)
Consulter à l’aide de différentes applications sur iPhone, iPad, Android ou Windows Phone -
Mobi (Kindle) (288.9 KB)
Consulter sur un appareil Kindle ou à l’aide d’une application Kindle sur plusieurs appareils
Langage exempt de préjugés
Dans le cadre de la documentation associée à ce produit, nous nous efforçons d’utiliser un langage exempt de préjugés. Dans cet ensemble de documents, le langage exempt de discrimination renvoie à une langue qui exclut la discrimination en fonction de l’âge, des handicaps, du genre, de l’appartenance raciale de l’identité ethnique, de l’orientation sexuelle, de la situation socio-économique et de l’intersectionnalité. Des exceptions peuvent s’appliquer dans les documents si le langage est codé en dur dans les interfaces utilisateurs du produit logiciel, si le langage utilisé est basé sur la documentation RFP ou si le langage utilisé provient d’un produit tiers référencé. Découvrez comment Cisco utilise le langage inclusif.
À propos de cette traduction
Cisco a traduit ce document en traduction automatisée vérifiée par une personne dans le cadre d’un service mondial permettant à nos utilisateurs d’obtenir le contenu d’assistance dans leur propre langue. Il convient cependant de noter que même la meilleure traduction automatisée ne sera pas aussi précise que celle fournie par un traducteur professionnel.
Table des matières
Introduction
Ce document décrit comment dépanner des problèmes de CPU élevés sur un routeur de la gamme ASR1000.
Prérequis
Exigences
Cisco recommande que vous compreniez l'architecture ASR1000 pour interpréter et utiliser ce document.
Description
Une utilisation CPU élevée sur un routeur Cisco peut être définie comme la condition dans laquelle l'utilisation CPU sur le routeur est supérieure à l'utilisation normale. Dans certains scénarios, l'utilisation accrue du processeur est attendue, alors que dans d'autres, cela peut indiquer un problème. L'utilisation élevée transitoire de l'UC sur le routeur en raison d'une modification du réseau ou de la configuration peut être ignorée et son comportement est attendu.
Cependant, un routeur qui connaît une utilisation élevée de l’UC pendant de longues périodes sans aucune modification du réseau ou de la configuration est inhabituel et doit être analysé. Par conséquent, lorsqu’il est surutilisé, l’UC n’est pas en mesure de servir activement tous les autres processus, ce qui entraîne une ligne de commande lente, une latence du plan de contrôle, des abandons de paquets et une défaillance des services.
Les causes d'une CPU élevée sont les suivantes :
- Le processeur du plan de contrôle reçoit trop de trafic ponctuel
- Processus qui se comporte de manière inattendue et entraîne une surexploitation du processeur
- Le processeur du plan de données est surutilisé/surabonné
- Trop d'interruptions du processeur
Un CPU élevé n'est pas toujours un problème de routeur de la gamme ASR1000, car l'utilisation du CPU du routeur est directement proportionnelle à la charge sur le routeur. Par exemple, en cas de modification du réseau, le trafic du plan de contrôle sera important, car le réseau reconvergera. Par conséquent, nous devons déterminer la cause première de la surutilisation du CPU afin de déterminer s'il s'agit d'un comportement attendu ou d'un problème.
Voici un diagramme qui détaille un processus étape par étape sur la façon de dépanner un problème de CPU élevé :
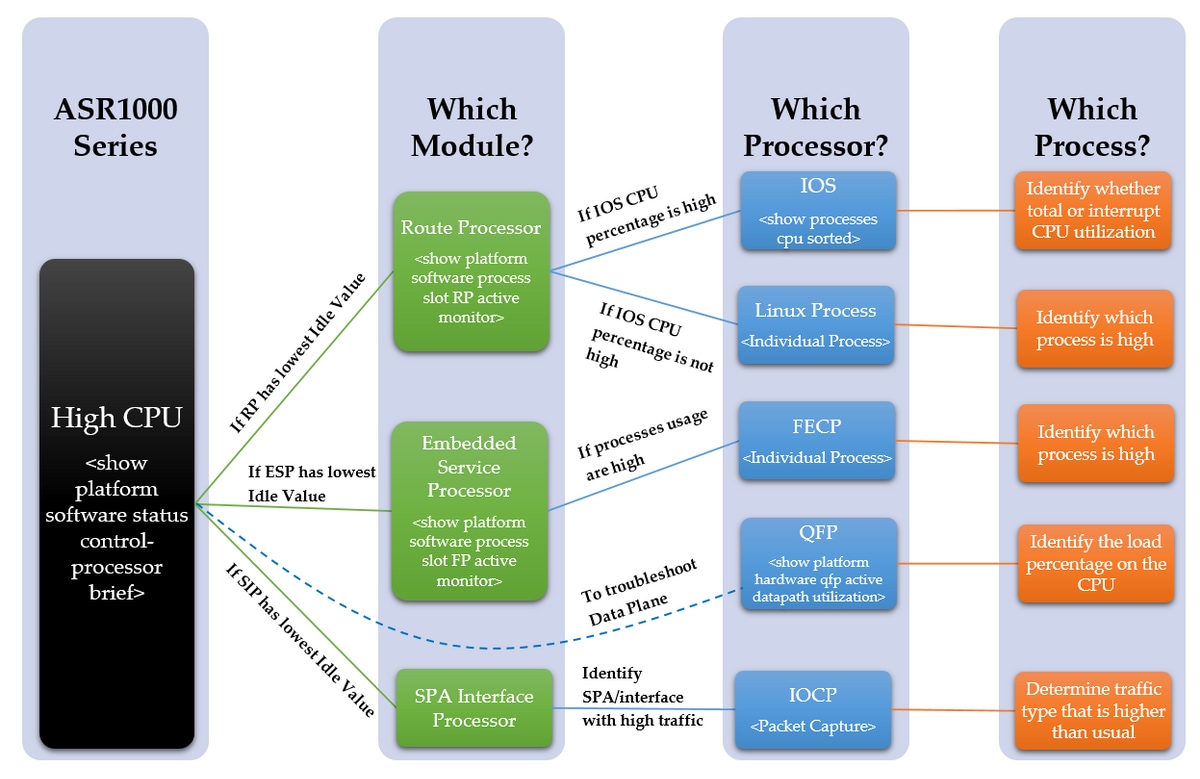
Étapes de dépannage
Étape 1 - Identifiez le module doté d'un processeur élevé
L'ASR1000 dispose de plusieurs processeurs différents sur les différents modules. Par conséquent, nous devons voir quel module présente une utilisation supérieure à la normale. Ceci peut être vu à travers la valeur Idle, comme plus la valeur d'inactivité est faible, plus l'utilisation CPU de ce module est élevée. Ces différents processeurs reflètent tous le plan de contrôle des modules.
Déterminez quel module du périphérique présente un niveau de CPU élevé. Est-ce le RP, ESP ou SIP avec la commande ci-dessous ?
show platform software status control-processor brief
Reportez-vous au résultat ci-dessous pour afficher la colonne mise en surbrillance
Si le RP a une faible valeur Idle, passez à l'étape 2, point 1
Si la valeur d'inactivité de l'ESP est faible, passez à l'étape 3, point 2
Si la valeur du SIP est faible, passez à l'étape 4, point 3
Router#show platform software status control-processor brief
Charge moyenne
État du logement 1-Min 5-Min 15-Min
RP0 Sain 0,00 0,02 0,00
ESP0 Sain 0,01 0,02 0,00
SIP0 Sain 0,00 0,01 0,00
Mémoire (Ko)
État Du Logement Total Utilisé (Pct) Libre (Pct) Validé (Pct)
RP0 Saine 2009376 1879196 (94 %) 130180 ( 6 %) 1432748 (71 %)
ESP0 Healthy 2009400 692100 (34 %) 1317300 (66 %) 472536 (24 %)
SIP0 Healthy 471804 284424 (60 %) 187380 (40 %) 193148 (41 %)
Utilisation du processeur
Logement CPU Système utilisateur Nice Idle IRQ SIRQ IOwait
RP0 0 2,59 2,49 0,00 94,80 0,00 0,09 0,00
ESP0 0 2,30 17,90 0,00 79,80 0,00 0,00 0,00
SIP0 0 1,29 4,19 0,00 94,41 0,09 0,00 0,00
Si les valeurs d'inactivité sont toutes relativement élevées, cela peut ne pas être un problème de plan de contrôle. Pour dépanner le plan de données, le QFP de l'ESP doit être observé. Des symptômes de « CPU élevé » peuvent encore être observés en raison d'un QFP surutilisé, ce qui n'entraînera pas de CPU élevé sur les processeurs du plan de contrôle. Passez à l'ÉTAPE 6.
Étape 2 - Analysez le module
- Processeur de routage
Vérifiez dans le RP quel processeur est observé avec une utilisation CPU élevée avec la commande ci-dessous. S’agit-il du processus Linux ou de l’IOS ?
show platform software process slot RP active monitor
Si le pourcentage de CPU IOS est élevé (linux_iosd-imag), alors est-ce que c'est l'IOS RP. Passez à l'ÉTAPE 3
Si le pourcentage de CPU des autres processus est élevé, il s'agit probablement du processus Linux. Passez à l'ÉTAPE 4
- Processeur de services intégrés
Vérifiez dans l'ESP si le processeur du plan de contrôle présente une utilisation CPU élevée. C'est la FECP ?
show platform software process slot FP active monitor
Si les processus sont élevés, il s'agit du protocole FECP, puis passez à l'étape 5
S'il ne s'agit pas du protocole FECP, il ne s'agit pas d'un problème lié aux processus du plan de contrôle dans l'ESP. Si des symptômes tels que la latence du réseau ou les pertes de file d'attente sont toujours observés, le plan de données peut nécessiter une révision pour éviter une surexploitation. Passez à l'ÉTAPE 6
- Processeur d'interface SPA
Si le SIP présente une utilisation CPU élevée, l'IOCP présente une utilisation CPU élevée. Déterminez le ou les processus de l’IOCP qui présentent une utilisation élevée du CPU.
Effectuez une capture de paquets et identifiez le trafic plus élevé que d’habitude et les processus associés à ce type de trafic. Passez à l’ÉTAPE 7
Étape 3 - Processus IOS
Reportez-vous au résultat ci-dessous. Le premier pourcentage correspond à l'utilisation totale du processeur et le second à l'utilisation du processeur d'interruption, qui correspond à la quantité de processeur utilisée pour traiter les paquets renvoyés.
Si le pourcentage d'interruption est élevé, cela signifie qu'une grande quantité de trafic est envoyée au RP (ceci peut être confirmé avec la commande show platform software infrastructure punt)
Si le pourcentage d'interruption est faible, mais que le CPU total est élevé, un ou plusieurs processus seront observés pour utiliser le CPU pendant une période prolongée.
Vérifiez dans l’IOS quel(s) processus est/sont observé(s) avec une utilisation CPU élevée avec la commande ci-dessous.
show processes cpu sorted
Identifiez le pourcentage élevé (CPU totale ou CPU d'interruption), puis identifiez le ou les processus individuels si nécessaire. Passez à l'ÉTAPE 7
Router#show processes cpu tri
Utilisation du processeur pendant cinq secondes : 0% / 0%; une minute : 1%; cinq minutes : 1%
PID Runtime(ms) Invoked Secs 5Sec 1Min 5Min TTY Process
PID Runtime(ms) Invoked Secs 5Sec 1Min 5Min TTY Process
188 8143 434758 18 0,15 % 0,18 % 0,19 % 0 Ethernet Msec Ti
515 380 7050 53 0,07% 0,00% 0,00% 0 Processus principal SBC
3 2154 215 10018 0,07% 0,00% 0,19% 0 Exec
380 1783 55002 32 0,07% 0,06% 0,06% 0 MMA DB TIMER
63 3132 11143 281 0,07% 0,07% 0,07% 0 tâche ipc IOSD
5 1 2 500 0,00% 0,00% 0,00% 0 Dispatc IPC ISSU
6 19 12 1583 0,00% 0,00% 0,00% 0 RF Esclave Main Th
8 0 1 0 0.00% 0.00% 0.00% 0 RO Notify Timers
7 0 1 0 0,00% 0,00% 0,00% 0 EDDRI_MAIN
10 6 75 80 0,00% 0,00% 0,00% 0 Gestionnaire de pool
9 5671 538 10540 0,00% 0,14% 0,12% 0 Vérifier les tas
Étape 4 - Processus Linux
Si l'IOS a surutilisé le CPU, alors nous devons observer l'utilisation du CPU pour le processus Linux individuel. Ces processus sont les autres processus répertoriés dans le moniteur actif RP de logement de processus du logiciel show platform. Identifiez le ou les processus qui présentent un niveau élevé de CPU, puis passez à l'étape 7.
Étape 5 - Processus du PCIE
Si un ou plusieurs processus sont élevés, il est probable que ce sont les processus au sein du FECP qui sont responsables de l'utilisation élevée du CPU, passez à l'ÉTAPE 7
Étape 6 - Utilisation du QFP
Le processeur de flux quantique est l'ASIC de transfert. Pour déterminer la charge sur le moteur de transfert, le QFP peut être surveillé. La commande ci-dessous répertorie les paquets d'entrée et de sortie (prioritaires et non prioritaires) en paquets par seconde et en bits par seconde. La dernière ligne affiche la quantité totale de charge de CPU due au transfert de paquets en pourcentage.
show platform hardware qfp active datapath utilisation
Déterminez si les entrées ou les sorties sont élevées, affichez la charge du processus, puis passez à l'ÉTAPE 7
Routeur#show platform hardware qfp active utilisation du chemin de données
CPP 0 : Subdev 0 5 sec 1 min 5 min 60 min
Entrée: Priorité (pps) 0 0 0 0
(bits/s) 208 176 176 176
Non prioritaire (pps) 0 2 2 2
(bits/s) 64 784 784 784
Total (pps) 0 2 2 2
(bits/s) 272 960 960 960
Sortie : Priorité (pps) 0 0 0 0
(bits/s) 192 160 160 160
Non prioritaire (pps) 0 1 1 1
(bits/s) 0 6488 6496 6488
Total (pps) 0 1 1 1
(bits/s) 192 6648 6656 6648
Traitement : Charge (pct) 0 0 0 0
Étape 7 - Déterminez la cause première et identifiez le correctif
Avec le ou les processus qui sont observés pour avoir surutilisé le CPU identifié, il y a une meilleure idée de la raison pour laquelle le CPU élevé s'est produit. Pour continuer, recherchez les fonctions exécutées par le processus identifié. Cela vous aidera à déterminer un plan d'action sur la façon d'aborder le problème. Par exemple : si le processus est responsable d'un protocole particulier, vous pouvez examiner la configuration associée à ce protocole.
Si vous rencontrez toujours des problèmes liés à l'UC, il est recommandé de contacter le TAC pour permettre à un ingénieur de vous aider à poursuivre le dépannage. Les étapes de dépannage ci-dessus aideront l'ingénieur à isoler le problème plus efficacement.
Exemple de dépannage
Dans cet exemple, nous allons exécuter le processus de dépannage et essayer d'identifier au mieux une cause racine possible pour le CPU élevé du routeur. Pour commencer, déterminez quel module est observé pour faire l'expérience de la CPU élevée, nous avons le résultat suivant :
Router#show platform software status control-processor brief
Charge moyenne
État du logement 1-Min 5-Min 15-Min
RP0 Sain 0,66 0,15 0,05
ESP0 Sain 0,00 0,00 0,00
SIP0 Sain 0,00 0,00 0,00
Mémoire (Ko)
État Du Logement Total Utilisé (Pct) Libre (Pct) Validé (Pct)
RP0 Saine 2009376 1879196 (94 %) 130180 ( 6 %) 1432756 (71 %)
ESP0 Healthy 2009400 692472 (34 %) 1316928 (66 %) 472668 (24 %)
SIP0 Healthy 471804 284556 (60 %) 187248 (40 %) 193148 (41 %)
Utilisation du processeur
Logement CPU Système utilisateur Nice Idle IRQ SIRQ IOwait
RP0 0 57,11 14,42 0,00 0,00 28,25 0,19 0,00
ESP0 0 2,10 17,91 0,00 79,97 0,00 0,00 0,00
SIP0 0 1,20 6,00 0,00 92,80 0,00 0,00 0,00
Comme la quantité d'inactivité dans RP0 est très faible, cela suggère un problème de CPU élevé dans le processeur de routage. Par conséquent, pour poursuivre le dépannage, nous identifierons le processeur du RP qui présente une CPU élevée.
Router#show processes cpu tri
Utilisation du processeur pendant cinq secondes : 84% / 36%; une minute : 34%; cinq minutes : 9%
PID Runtime(ms) Invoked Secs 5Sec 1Min 5Min TTY Process
107 303230 50749 5975 46,69 % 18,12 % 4,45 % 0 IOSXE-RP Punt Se
63 105617 540091 195 0,23% 0,10% 0,08% 0 tâche ipc IOSD
159 74792 2645991 28 0,15% 0,06% 0,06% 0 VRRS Fil principal
116 53685 169683 316 0,15% 0,05% 0,01% 0 Emplois Par Seconde
9 305547 26511 11525 0,15 % 0,28 % 0,16 % 0 Vérifier les tas
188 362507 20979154 17 0,15 % 0,15 % 0,19 % 0 Ethernet Msec Ti
3 147 186 790 0,07% 0,08% 0,02% 0 Exec
2 32126 33935 946 0.07% 0.03% 0.00% 0 Chargemètre
446 416 33932 12 0,07% 0,00% 0,00% 0 Processus VDC
164 59945 5261819 11 0,07% 0,04% 0,02% 0 Âge de nouvelle tentative IP ARP
43 1703 16969 100 0,07% 0,00% 0,00% 0 IPC Maintien en vie M
A partir de ce résultat, on peut observer que le pourcentage total de CPU et le pourcentage d'interruption sont plus élevés que prévu. Le processus supérieur qui utilise le CPU est le «IOSXE-RP Punt Se» qui est le processus qui gère le trafic pour le CPU RP, par conséquent, nous pouvons examiner plus en détail ce trafic qui est envoyé au RP.
Routeur#show platform infrastructure logicielle punt
Statistiques internes de l'interface LSMPI :
activé=0, désactivé=0, limité=0, non limité=0, état prêt
Tampons d'entrée = 90100722
Tampons de sortie = 100439
nombre de rxdone = 90100722
nombre txdone = 100436
Rx no particletype count = 0
Tx no particletype count = 0
Txbuf du nombre d'ombres = 0
Pas de début de paquet = 0
Pas de fin de paquet = 0
Statistiques de chute ponctuelle :
Version 0 incorrecte
Type 0 incorrect
En-tête de fonction 0
En-tête 0 de plate-forme
En-tête de fonction manquant 0
Incompatibilité d'en-tête commune 0
Longueur totale 0 incorrecte
Longueur de paquet 0 incorrecte
Décalage réseau 0 incorrect
Pas en-tête 0
Type de liaison 0 inconnu
Pas de swib 1
En-tête de fonctionnalité ESS 0 incorrect
Aucune fonctionnalité ESS 0
Aucune fonctionnalité SSLVPN 0
Punt pour nous type inconnu 0
Cause ponctuelle hors limites 0
Causes du paquet Punt IOSXE-RP :
6221026 Contrôle de couche2 et paquets hérités
147 paquets de requête ou de réponse ARP
27801234 Paquets de données For-us
84426 Paquets de test d'activité RP<->QFP
6 Glean adjacency packets
1647 Paquets de contrôle pour utilisateur
FOR_US Statistiques du protocole IPv4 de contrôle :
1647 paquets OSPF
Histogramme de paquets (500 octets/bin), taille moyenne en 92, sur 56 :
Pak-Size In-Count Out-Count
0+ : 90097805 98790
Plus de 500 : 0 7
À partir de ce résultat, nous pouvons voir qu'il y a une grande quantité de paquets dans le « Pour-us paquets de données » qui indique le trafic dirigé vers le routeur, ce compteur a été confirmé pour être incrémenté à partir de l'observation de la commande plusieurs fois sur plusieurs minutes. Cela confirme que le CPU est surutilisé par une grande quantité de trafic pointé, qui est souvent le trafic du plan de contrôle. Le trafic du plan de contrôle peut inclure ARP, SSH, SNMP, les mises à jour de route (BGP, EIGRP, OSPF), etc. À partir de ces informations, nous sommes en mesure d'identifier la cause potentielle de la CPU élevée et cela aide à dépanner la cause racine. Par exemple, une capture de paquets ou un moniteur de trafic différent pourrait être mis en oeuvre pour voir le trafic exact envoyé au RP, ce qui permettrait d'identifier la cause première et de la résoudre pour éviter un problème similaire à l'avenir.
Une fois la capture de paquets terminée, voici quelques exemples de trafic potentiel pointé :
- ARP : Cela peut être dû à un nombre excessif de requêtes ARP, ce qui se produirait si plusieurs adresses IP envoyaient des requêtes ARP via la configuration d'une route IP à une interface de diffusion. Cela peut également être dû à des entrées vidées de la table ARP et devra être réappris en fonction des entrées d'adresses MAC qui expirent, ou des interfaces qui s'activent ou s'arrêtent.
- SSH : Cela peut entraîner une utilisation CPU élevée en raison d'une commande show volumineuse (show tech-support) ou lorsque de nombreuses commandes debug sont activées, ce qui force l'envoi d'une grande quantité de CLI sur la session SSH.
- SNMP: Cela peut être dû au fait que l'agent SNMP met beaucoup de temps à traiter une requête, ce qui entraîne une CPU élevée. Souvent, deux causes probables sont les MIB qui sont interrogées, ou les tables de routage et/ou ARP qui sont interrogées par le NMS.
- Mises à jour de routage : Souvent, un afflux de mises à jour de route est dû à une re-convergence du réseau ou à des défauts de liaison. Cela peut indiquer des routes qui s’arrêtent au sein du réseau, ou des périphériques entiers qui s’arrêtent, ce qui force le réseau à converger et à recalculer les meilleures routes, en fonction du protocole de routage utilisé.
Cela met en évidence la façon dont la cause première peut être isolée par l'identification de la cause de la CPU élevée, lorsqu'il s'agit d'un niveau de processus individuel. À partir de là, le processus ou le protocole individuel peut être analysé séparément pour déterminer s'il s'agit d'un problème de configuration, d'un problème logiciel, d'une conception de réseau ou d'une pratique prévue.
Commandes supplémentaires
La liste ci-dessous répertorie d'autres commandes utiles à utiliser et est triée par processeur auquel elles se rapportent :
Processeur de routage
- <show process cpu history>
- Fournit un graphique de l'historique du processeur au cours des 60 dernières secondes, minutes et 72 heures
- <show process process_ID>
- Informations détaillées sur la mémoire de processus individuelle et les allocations de CPU
- <show platform software infrastructure punt>
- Fournit des informations sur tout le trafic qui est envoyé au RP
- <show platform software status control-processor brief>
- Détaille la charge et l'état du processeur, ainsi que les statistiques de la mémoire et du module
- <show platform software process slot r0|r1 monitor>
- Détaille les différents processus et leurs allocations de CPU et de mémoire sur le module sélectionné
- <surveiller le processus logiciel de la plate-forme r0|r1>
- Fournit un flux en direct qui met à jour les processus lorsqu'ils utilisent le processeur
- Nécessite que la commande « terminal terminal-type » soit entrée en mode de configuration globale pour fonctionner correctement
Processeur de services intégrés
- <show platform software process list fp active summary>
- Le détaille un résumé de tous les processus qui sont exécutés sur le processeur, ainsi que la charge moyenne
- <show platform software process slot f0|f1 monitor>
- Détaille les différents processus et leurs allocations de CPU et de mémoire sur le module sélectionné
- <surveillance du processus logiciel de la plate-forme f0|f1>
- Fournit un flux en direct qui met à jour les processus tels qu'ils utilisent le processeur
- Nécessite que la commande « terminal terminal-type » soit entrée en mode de configuration globale pour fonctionner correctement
Contribution d’experts de Cisco
- Chris CourtelisCisco Systems
 Commentaires
Contacter Cisco
- Ouvrir un dossier d’assistance

- (Un contrat de service de Cisco est requis)