تم حظر قوائم انتظار معالجة الأحداث
قابلية التطبيق
مؤسسة Splunkالوصف
إضافة بعض البيانات مباشرة إلى المفهرسين، وتقوم بعض المصادر بإرسال البيانات عبر مزودي الخدمة الثقيلين.إستجلاء
1. في splunkd.log هناك أخطاء في تقسيم السطور و AggregatorMiningProcessor لعدد قليل من أنواع المصادر.
WARN  AggregatorMiningProcessor - Breaking event because limit of 256 has been exceeded - data_source="/path/to/the/logs/", data_host="hostname.com",
data_sourcetype="sourcetype_name"WARN  AggregatorMiningProcessor - Breaking event because limit of 1000 has been exceeded - data_source="/path/to/the/logs/"", data_host="other_hostname.com",
data_sourcetype="other_sourcetype_name"
2. تظهر لوحة معلومات أداء الفهرسة معالج تقسيم "المجمع" يتلقى معالجة عالية لوحدة المعالجة المركزية.
3. لم يتم حل إصلاح أنواع المصادر التي تسبب الأخطاء (تم تجاوز الأخطاء، وبقيت المشكلة).
4. هناك إزدحام في قائمة انتظار التجميع، يظهر pstack أن معالج التجميع مشغول بدمج الخطوط في حدث واحد، مما يؤدي إلى حدوث إزدحام.
تحدث هذه المشكلة عندما يقوم معالج التجميع بدمج عدد كبير من الخطوط في حدث واحد. من الرمز، كلما كان هناك سطر واحد بحاجة إلى دمجه إلى الأحداث الحالية، كان هناك السلسلة::تم إجراء نقل الذاكرة والاحتياط كالتعليمات البرمجية التالية. لذا، إذا كان هناك 1000 خط لحدث واحد، سيكون هناك 1000 مرة من الاحتياط و التفكير.
void CowPipelineData::appendAndReset(CowPipelineData& other)
{
...
            _pd->_rawAsStr.reserve(_pd->_rawSeg.size() + other._pd->_rawSeg.size() + 1);
            append_other_raw:
            _pd->_rawAsStr.push_back('\n');
            _pd->_rawAsStr.append(other._pd->_rawSeg);
...
}
اجمع بعض الأحداث النموذجية التي تحتوي على عدد كبير من البنود، لمعرفة الأحداث التي تتسبب في حدوث المشكلة، لتحديد نوع المصدر الثلاثة الأول الذي يحتوي على عدد كبير من الخطوط الإجمالية:
| tstats count where index=* OR index=_* by linecount sourcetype
| where linecount > 2
| stats sum(eval(linecount*count)) as totallines by sourcetype
| sort -totallines
المفهوم:
السبب هو:
- عادة ما يكون لدينا قائمة انتظار التحليل كقائمة انتظار أولى وقائمة انتظار تجميع كالثانية.
- يتم تحليل قائمة الانتظار لتحليل بيانات الدفق إلى خطوط بشكل افتراضي \r\n في حالة عدم تعريف LINE_BREAKER.
- بعد ذلك، تقوم قائمة انتظار التجميع بدمج الخطوط استنادا إلى التكوين مثلTIME_FORMAT أو غيرها
- بإعداد LINE_BREAKER، يمكن أن يخبر SPLUNK كيفية توزيع بيانات الدفق إلى خطوط في مرحلة التحليل و
- بتعيين SHOULD_LINEMERGE = false يشير إلى أن عملية التجميع يجب ألا تدمج الخطوط في الأحداث.
- إذا في الأساس، Line_Breaker و SHOULD_LINEMERGE = false سيكون حلا لمشكلة العملاء.
قرار
1. قم بتمكين مقاييس وقت وحدة المعالجة المركزية (CPU) ل agg_processor لأغراض تصحيح الأخطاء من خلال تغيير limit.conf كما يلي:
.../limits.conf
[default]
agg_cpu_profiling = true
2. قم بتشغيل البحث أدناه لتحديد نوع المصدر الذي يفرض المزيد من الضغط على معالج التجميع:
index=_internal source=*metrics.log* per_sourcetype_agg_cpu Metrics
| timechart span=10s avg(cpu) by series
3. إعداد SHOULD_LINEMERGE إلى "false" وكتابة regex ل "line_breaker" لكل نوع مصدر يدخل في الرسم البياني للبحث. يوجد أدناه برنامج EXP الذي أخذته من مستند تدريب أستكشاف المشكلات وإصلاحها.
ملاحظة: لقطة شاشة توضح البحث عن معالج regex: 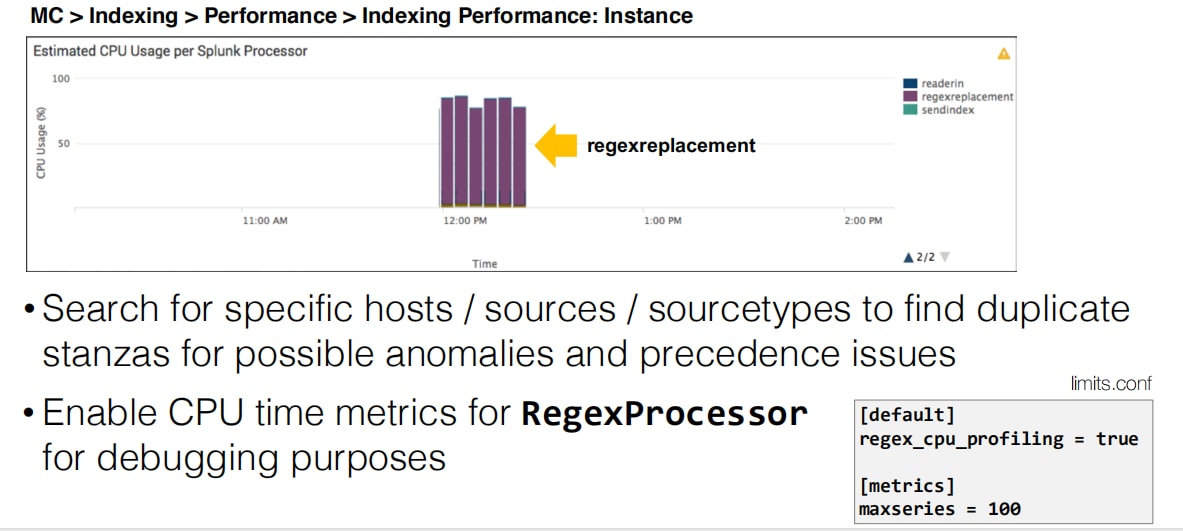
4. سيؤدي إصلاح كافة أنواع المصادر مثل ذلك إلى حل مشكلة تعبئة قائمة الانتظار.
مورد إضافي:
يظهر الفيديو التالي من ساعات مكتب المجتمع المزيد من العمق في كيفية أستكشاف أخطاء قوائم الانتظار المحظورة وإصلاحها.
روابط ذات صلة
كتيب LIMIT.confhttps://docs.splunk.com/Documentation/Splunk/7.3.0/Admin/Limitsconf
محفوظات المراجعة
| المراجعة | تاريخ النشر | التعليقات |
|---|---|---|
1.0 |
28-Sep-2026
|
الإصدار الأولي |
 التعليقات
