Solución de problemas de uso elevado de CPU en el router de la serie ASR1000

Opciones de descarga
-
ePub (467.5 KB)
Visualice en diferentes aplicaciones en iPhone, iPad, Android, Sony Reader o Windows Phone -
Mobi (Kindle) (291.4 KB)
Visualice en dispositivo Kindle o aplicación Kindle en múltiples dispositivos
Lenguaje no discriminatorio
El conjunto de documentos para este producto aspira al uso de un lenguaje no discriminatorio. A los fines de esta documentación, "no discriminatorio" se refiere al lenguaje que no implica discriminación por motivos de edad, discapacidad, género, identidad de raza, identidad étnica, orientación sexual, nivel socioeconómico e interseccionalidad. Puede haber excepciones en la documentación debido al lenguaje que se encuentra ya en las interfaces de usuario del software del producto, el lenguaje utilizado en función de la documentación de la RFP o el lenguaje utilizado por un producto de terceros al que se hace referencia. Obtenga más información sobre cómo Cisco utiliza el lenguaje inclusivo.
Acerca de esta traducción
Cisco ha traducido este documento combinando la traducción automática y los recursos humanos a fin de ofrecer a nuestros usuarios en todo el mundo contenido en su propio idioma. Tenga en cuenta que incluso la mejor traducción automática podría no ser tan precisa como la proporcionada por un traductor profesional. Cisco Systems, Inc. no asume ninguna responsabilidad por la precisión de estas traducciones y recomienda remitirse siempre al documento original escrito en inglés (insertar vínculo URL).
Contenido
Introducción
Este documento describe cómo resolver problemas de uso excesivo de la CPU en un router de la serie ASR1000.
Requisito previo
Requirements
Cisco recomienda que comprenda la arquitectura ASR1000 para interpretar y utilizar este documento.
Descripción
Una CPU alta en un router Cisco se puede definir como la condición en la que el uso de la CPU en el router está por encima del uso normal. En algunos escenarios se espera un mayor uso de la CPU, mientras que en otros escenarios podría indicar un problema. El uso excesivo y transitorio de la CPU en el router debido a un cambio en la configuración o en la red puede ignorarse y se espera un comportamiento.
Sin embargo, un router que experimenta una alta utilización de la CPU durante períodos prolongados sin ningún cambio en la red o la configuración es inusual y debe analizarse. Por lo tanto, cuando se utiliza en exceso, la CPU no puede atender activamente todos los demás procesos, lo que resulta en una línea de comandos lenta, latencia del plano de control, caídas de paquetes y la falla de los servicios.
Las causas de un uso elevado de la CPU son:
- La CPU del plano de control recibe demasiado tráfico punt
- Proceso que se comporta de forma inesperada y da lugar a un uso excesivo de la CPU
- El procesador del plano de datos está sobreutilizado/sobresuscrito
- Demasiadas interrupciones del procesador
Una CPU alta no siempre es un problema del router de la serie ASR1000, ya que la utilización de la CPU del router es directamente proporcional a la carga en el router. Por ejemplo, si se produce un cambio en la red, esto provocará una gran cantidad de tráfico en el plano de control, ya que la red volverá a converger. Por lo tanto, necesitamos determinar la causa raíz de la sobreutilización de la CPU para determinar si se espera un comportamiento o un problema.
A continuación se muestra un diagrama que detalla un proceso paso a paso sobre cómo resolver un problema de CPU alta:
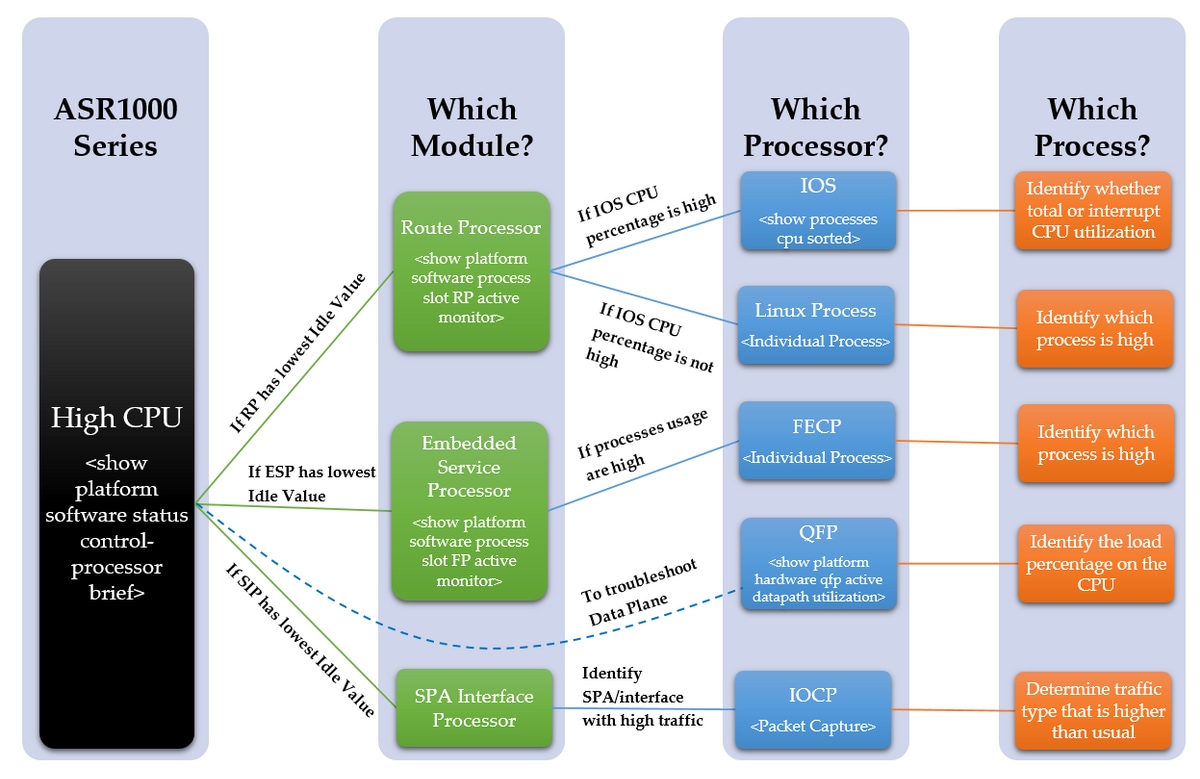
Pasos de Troubleshooting
Paso 1 - Identificar el módulo con una CPU alta
ASR1000 tiene varias CPU diferentes en los distintos módulos. Por lo tanto, necesitamos ver qué módulo muestra un uso mayor que el normal. Esto se puede ver a través del valor de inactividad, ya que cuanto menor sea el valor de inactividad, mayor será la utilización de la CPU de ese módulo. Todas estas CPU diferentes reflejan el plano de control de los módulos.
Determine qué módulo del dispositivo experimenta un uso elevado de la CPU. ¿Es RP, ESP o SIP con el siguiente comando?
show platform software status control-processor brief
Consulte el siguiente resultado para ver la columna resaltada
Si el RP tiene un valor de inactividad bajo, vaya al paso 2, punto 1
Si el ESP tiene un valor de inactividad bajo, vaya al paso 3, punto 2
Si el SIP tiene un valor de inactividad bajo, vaya al paso 4, punto 3
Router#show platform software status control-processor brief
Carga media
Estado De La Ranura 1-Min 5-Min 15-Min
RP0 Correcto 0,00 0,02 0,00
ESP0 Saludable 0,01 0,02 0,00
SIP0 Correcto 0,00 0,01 0,00
Memoria (kB)
Estado De Ranura Total Usado (Pct) Libre (Pct) Comprometido (Pct)
RP0 Correcto 2009376 1879196 (94%) 130180 ( 6%) 1432748 (71%)
ESP0 Saludable 2009400 692100 (34%) 1317300 (66%) 472536 (24%)
SIP0 Saludable 471804 284424 (60%) 187380 (40%) 193148 (41%)
Utilización de la CPU
Slot CPU User System Nice Idle IRQ SIRQ IOwait
RP0 0 2,59 2,49 0,00 94,80 0,00 0,09 0,00
ESP0 0 2,30 17,90 0,00 79,80 0,00 0,00 0,00
SIP0 0 1,29 4,19 0,00 94,41 0,09 0,00 0,00
Si todos los valores de inactividad son relativamente altos, puede que no sea un problema del plano de control. Para solucionar problemas del plano de datos, debe observarse el QFP de ESP. Aún se pueden observar síntomas de "CPU alta" debido a un QFP sobreutilizado, que no resultará en una CPU alta en los procesadores del plano de control. Proceda al Paso 6.
Paso 2 - Analizar el módulo
- Procesador de ruteo
Confirme dentro del RP qué procesador se observa que tiene un uso elevado de la CPU con el siguiente comando. ¿Es el proceso de Linux o el IOS?
show platform software process slot RP active monitor
Si el porcentaje de CPU IOS es alto (linux_iosd-image), entonces es el RP IOS. Proceda al Paso 3
Si el porcentaje de CPU de otros procesos es alto, entonces es probable que sea el Proceso Linux. Proceda al Paso 4
- Procesador de servicios integrados
Confirme dentro del ESP si se observa que el procesador del plano de control tiene un uso elevado de la CPU. ¿Es la FECP?
show platform software process slot FP active monitor
Si los procesos son altos, entonces es el FECP, luego continúe con el PASO 5
Si no es el FECP, no es un problema relacionado con los procesos del plano de control dentro del ESP. Si se siguen observando síntomas como la latencia de la red o las caídas de la cola, es posible que sea necesario revisar el plano de datos para comprobar si se ha producido una sobreutilización. Proceda al Paso 6
- Procesador de interfaz SPA
Si se observa que el SIP tiene un uso elevado de la CPU, se observará que el IOCP tiene un uso elevado de la CPU. Determine qué procesos dentro del IOCP se observa que tienen una alta utilización de la CPU.
Realice una captura de paquetes e identifique qué tráfico es más alto de lo habitual y qué procesos están asociados con este tipo de tráfico. Vaya al PASO 7
Paso 3 - Procesos IOS
Consulte el siguiente resultado, el primer porcentaje es la utilización total de la CPU y el segundo porcentaje es la utilización de la CPU de interrupción, que es la cantidad de CPU utilizada para procesar paquetes punteados.
Si el porcentaje de interrupción es alto, significa que una gran cantidad de tráfico se dirige al RP (esto se puede confirmar con el comando show platform software infrastructure punt)
Si el porcentaje de interrupción es bajo, pero la CPU total es alta, entonces hay un proceso o procesos que se observarán para utilizar la CPU durante un período prolongado.
Confirme dentro del IOS qué proceso o procesos se observa que tienen un uso elevado de la CPU con el siguiente comando.
show processes cpu sorted
Identifique qué porcentaje es alto (CPU total o CPU de interrupción) y, si es necesario, identifique los procesos individuales. Proceda al Paso 7
Router#show processes cpu sorted
Utilización de la CPU durante cinco segundos: 0% / 0%; un minuto: 1%; cinco minutos: 1%
Tiempo de ejecución PID (ms) Invocado Secs 5 Seg 1 Min 5 Min Proceso TTY
Tiempo de ejecución PID (ms) Invocado Secs 5 Seg 1 Min 5 Min Proceso TTY
188 8143 434758 18 0,15% 0,18% 0,19% 0 Ethernet Msec Ti
515 380 7050 53 0,07% 0,00% 0,00% 0 SBC proceso principal
3 2154 215 10018 0,07% 0,00% 0,19% 0 Exec
380 1783 55002 32 0,07% 0,06% 0,06% 0 MMA DB TIMER
63 3132 11143 281 0,07% 0,07% 0,07% 0 IOSD ipc task
5 1 2 500 0,00% 0,00% 0,00% 0 IPC ISSU Distribution
6 19 12 1583 0,00% 0,00% 0,00% 0 RF Esclavo Principal Th
8 0 1 0 0,00% 0,00% 0,00% 0 RO Notify Timers
7 0 1 0 0,00% 0,00% 0,00% 0 EDDRI_MAIN
10 6 75 80 0,00% 0,00% 0,00% 0 Administrador de grupos
9 5671 538 10540 0,00% 0,14% 0,12% 0 Comprobar montones
Paso 4: Procesos de Linux
Si se observa que el IOS ha sobreutilizado la CPU, entonces necesitamos observar la utilización de la CPU para el proceso individual de linux. Estos procesos son los otros procesos enumerados en el monitor activo show platform software process slot RP. Identifique qué procesos experimentan un uso elevado de la CPU y, a continuación, vaya al PASO 7.
Paso 5: Procesos FECP
Si un proceso o procesos son altos, es probable que sean los procesos dentro de FECP los responsables de la alta utilización de la CPU, continúe con el PASO 7
Paso 6 - Utilización de QFP
Quantum Flow Processor es el ASIC de reenvío. Para determinar la carga en el motor de reenvío, se puede monitorear el QFP. El siguiente comando enumera los paquetes de entrada y salida (prioritarios y no prioritarios) en paquetes por segundo y bits por segundo. La línea final muestra la cantidad total de carga de CPU debido al reenvío de paquetes en un porcentaje.
show platform hardware qfp active datapath utilization
Identifique si la entrada o la salida son altas, vea la carga del proceso y continúe con el PASO 7
Router#show platform hardware qfp active datapath utilization
CPP 0: Subdev 0 5 secs 1 min 5 min 60 min
Entrada: Prioridad (pps) 0 0 0
(bps) 208 176 176 176
Non-Priority (pps) 0 2 2 2
(bps) 64 784 784 784
Total (pp) 0 2 2 2
(bps) 272 960 960 960
Salida: Prioridad (pps) 0 0 0
(bps) 192 160 160 160
Non-Priority (pps) 0 1 1 1
(bps) 0 648 6496 6488
Total (pp) 0 1 1 1
(bps) 192 648 656 6648
Procesamiento: Carga (pct) 0 0 0 0
Paso 7 - Determinar la causa raíz e identificar la solución
Con el proceso o procesos que se observa que han sobreutilizado la CPU identificados, hay una imagen más clara de por qué se ha producido una CPU alta. Para continuar, investigue las funciones realizadas por el proceso identificado. Esto ayudará a determinar un plan de acción sobre cómo abordar el problema. Por ejemplo: si el proceso es responsable de un protocolo en particular, es posible que desee ver la configuración relacionada con este protocolo.
Si aún experimenta problemas relacionados con la CPU, se recomienda ponerse en contacto con el TAC para que un ingeniero le ayude a resolver los problemas. Los pasos anteriores para solucionar el problema ayudarán al ingeniero a aislar el problema de manera más eficiente.
Ejemplo de Troubleshooting
En este ejemplo, vamos a ejecutar el proceso para resolver problemas e intentar identificar mejor una posible causa raíz de la CPU alta del router. Para comenzar, determine qué módulo se observa que experimenta la CPU alta, tenemos el siguiente resultado:
Router#show platform software status control-processor brief
Carga media
Estado De La Ranura 1-Min 5-Min 15-Min
RP0 Correcto 0,66 0,15 0,05
ESP0 Saludable 0,00 0,00 0,00
SIP0 Correcto 0,00 0,00 0,00
Memoria (kB)
Estado De Ranura Total Usado (Pct) Libre (Pct) Comprometido (Pct)
RP0 Correcto 2009376 1879196 (94%) 130180 ( 6%) 1432756 (71%)
ESP0 Saludable 2009400 692472 (34%) 1316928 (66%) 472668 (24%)
SIP0 Saludable 471804 284556 (60%) 187248 (40%) 193148 (41%)
Utilización de la CPU
Slot CPU User System Nice Idle IRQ SIRQ IOwait
RP0 0 57.11 14.42 0.00 0.00 28.25 0.19 0.00
ESP0 0 2,10 17,91 0,00 79,97 0,00 0,00 0,00
SIP0 0 1,20 6,00 0,00 92,80 0,00 0,00 0,00
Como la cantidad de inactividad dentro de RP0 es muy baja, sugiere un problema de CPU alto dentro del procesador de ruta. Por lo tanto, para resolver más problemas, identificaremos qué procesador dentro del RP experimenta una CPU alta.
Router#show processes cpu sorted
Utilización de la CPU durante cinco segundos: 84% / 36%; un minuto: 34%; cinco minutos: 9%
Tiempo de ejecución PID (ms) Invocado Secs 5 Seg 1 Min 5 Min Proceso TTY
107 303230 50749 5975 46,69% 18,12% 4,45% 0 IOSXE-RP Punt Se
63 105617 540091 195 0.23% 0.10% 0.08% 0 IOSD ipc task
159 74792 2645991 28 0,15% 0,06% 0,06% 0 VRRS Rosca principal
116 53685 169683 316 0,15% 0,05% 0,01% 0 Trabajos por segundo
9 305547 26511 11525 0,15% 0,28% 0,16% 0 Comprobar montones
188 362507 20979154 17 0,15% 0,15% 0,19% 0 Mseg. Ethernet Ti
3 147 186 790 0,07% 0,08% 0,02% 0 Exec
2 32126 33935 946 0.07% 0.03% 0.00% 0 Medidor de carga
446 416 33932 12 0,07% 0,00% 0,00% 0 VCC proceso
164 59945 5261819 11 0.07% 0.04% 0.02% 0 IP ARP Retry Age
43 1703 16969 100 0,07% 0,00% 0,00% 0 IPC Mantener activo M
A partir de esta salida, se puede observar que el porcentaje total de CPU y el porcentaje de interrupción son más altos de lo esperado. El proceso principal que utiliza la CPU es el "IOSXE-RP Punt Se", que es el proceso que maneja el tráfico para la CPU RP, por lo tanto, podemos observar más en profundidad este tráfico que es impulsado al RP.
Router#show platform software infrastructure punt
Estadísticas internas de la interfaz LSMPI:
enabled=0, disabled=0, throttled=0, unthrottled=0, el estado es ready
Búferes de entrada = 90100722
Búferes de salida = 100439
rxdone count = 90100722
txdone count = 100436
Rx no particletype count = 0
Tx no particletype count = 0
Txbuf desde recuento de sombras = 0
Ningún inicio de paquete = 0
Sin fin de paquete = 0
Punt. estadísticas de descarte:
Versión incorrecta 0
Tipo 0 incorrecto
Tenía encabezado de característica 0
Cabecera de plataforma 0
Falta el encabezado de característica 0
Discordancia de encabezado común 0
Longitud total incorrecta 0
Longitud de paquete incorrecta 0
Desplazamiento de red incorrecto 0
No insertar encabezado 0
Tipo de link desconocido 0
Sin swidb 1
Encabezado de característica ESS incorrecto 0
Sin función ESS 0
Sin función SSLVPN 0
Punt For Us type unknown 0
Punt cause out of range 0
El paquete de inserción IOSXE-RP causa:
62210226 Control de capa 2 y paquetes heredados
147 paquetes de solicitud o respuesta ARP
27801234 Paquetes de datos para uso
84426 paquetes keepalive RP<->QFP
6 Obtener paquetes de adyacencia
1647 Paquetes de control para uso
Estadísticas del protocolo IPv4 de control FOR_US:
1647 paquetes OSPF
Histograma de paquetes (500 bytes/bin), tamaño promedio en 92, salida 56:
Pak-Size In-Count Out-Count
0+: 90097805 98790
+ de 500: 0 7
A partir de esta salida, podemos ver que hay una gran cantidad de paquetes en los "Paquetes de datos para uso" que indican el tráfico dirigido hacia el router, se confirmó que este contador se incrementó desde la observación del comando varias veces durante varios minutos. Esto confirma que la CPU está sobreutilizada por una gran cantidad de tráfico impulsado, que a menudo es tráfico del plano de control. El tráfico del plano de control puede incluir ARP, SSH, SNMP, actualizaciones de ruta (BGP, EIGRP, OSPF), etc. A partir de esta información, podemos identificar la causa potencial de la CPU alta y esto ayuda a resolver problemas de la causa raíz. Por ejemplo, se podría implementar una captura de paquetes o un monitor de tráfico diferente para ver el tráfico exacto dirigido al RP, lo que permitiría identificar y resolver la causa raíz para evitar un problema similar en el futuro.
Una vez que se completa una captura de paquetes, algunos ejemplos de tráfico punteado potencial son:
- ARP: Esto podría deberse a un número excesivo de solicitudes ARP, lo que ocurriría si varias direcciones IP enviaran solicitudes ARP a través de la configuración de una ruta IP a una interfaz de difusión. Esto también podría deberse a las entradas vaciadas de la tabla ARP y tendrá que volver a aprenderse en función de las entradas de la dirección MAC que caduquen o de las interfaces que se activen o desactiven.
- SSH: Esto podría causar un uso excesivo de la CPU debido a un comando show de gran tamaño (show tech-support) o cuando se habilitan muchos comandos de depuración, lo que obliga a enviar una gran cantidad de CLI a través de la sesión SSH.
- SNMP (Protocolo de administración de red simple): Esto podría deberse a que el agente SNMP tarda mucho tiempo en procesar una solicitud y, por lo tanto, provoca un uso excesivo de la CPU. A menudo, dos causas probables son las MIB que se sondean, o las tablas de ruteo y/o ARP que son sondeadas por el NMS.
- Actualizaciones de ruta: A menudo, la afluencia de actualizaciones de rutas se debe a una reconvergencia de la red o a las inestabilidades de los enlaces. Esto podría indicar rutas que caen dentro de la red, o dispositivos completos que caen, lo que obliga a la red a converger y recalcular las mejores rutas, lo que depende del protocolo de ruteo que esté en uso.
Esto resalta cómo la causa raíz se puede aislar a través de la identificación de la causa de la CPU alta, cuando se trata de un nivel de proceso individual. A partir de aquí, el proceso o protocolo individual se puede analizar de forma aislada para identificar si se trata de un problema de configuración, de software, de diseño de red o de una práctica deseada.
Comandos adicionales
La siguiente es una lista de otros comandos útiles adicionales que se deben utilizar y se ordenan según el procesador con el que se relacionan:
Procesador de ruteo
- <show process cpu history>
- Proporciona un gráfico del historial de la CPU durante los últimos 60 segundos, minutos y 72 horas
- <show process process_ID>
- Información detallada sobre asignaciones de CPU y memoria de proceso individual
- <show platform software infrastructure punt>
- Proporciona información sobre todo el tráfico que se envía al RP
- <show platform software status control-processor brief>
- Detalla la carga y el "estado" de la CPU, así como la memoria y las estadísticas del módulo
- <show platform software process slot r0|r1 monitor>
- Detalla los diferentes procesos y sus asignaciones de CPU y memoria en el módulo seleccionado
- <monitor platform software process r0|r1>
- Proporciona una fuente en directo que actualiza los procesos a medida que utilizan la CPU
- Requiere que el comando "terminal terminal-type" se ingrese en el modo de configuración global primero para funcionar correctamente
Procesador de servicios integrados
- <show platform software process list fp active summary>
- Detalla un resumen de todos los procesos que se ejecutan en la CPU, así como la carga promedio
- <show platform software process slot f0|f1 monitor>
- Detalla los diferentes procesos y sus asignaciones de CPU y memoria en el módulo seleccionado
- <monitor platform software process f0|f1>
- Proporciona una fuente en vivo que actualiza los procesos tal como se utilizan la CPU
- Requiere que el comando "terminal terminal-type" se ingrese en el modo de configuración global primero para funcionar correctamente
Con la colaboración de ingenieros de Cisco
- Chris CourtelisCisco Systems
 Comentarios
Contacte a Cisco
- Abrir un caso de soporte

- (Requiere un Cisco Service Contract)