Fehlerbehebung bei hoher CPU-Auslastung auf Routern der ASR1000-Serie

Download-Optionen
-
ePub (467.8 KB)
In verschiedenen Apps auf iPhone, iPad, Android, Sony Reader oder Windows Phone anzeigen
Inklusive Sprache
In dem Dokumentationssatz für dieses Produkt wird die Verwendung inklusiver Sprache angestrebt. Für die Zwecke dieses Dokumentationssatzes wird Sprache als „inklusiv“ verstanden, wenn sie keine Diskriminierung aufgrund von Alter, körperlicher und/oder geistiger Behinderung, Geschlechtszugehörigkeit und -identität, ethnischer Identität, sexueller Orientierung, sozioökonomischem Status und Intersektionalität impliziert. Dennoch können in der Dokumentation stilistische Abweichungen von diesem Bemühen auftreten, wenn Text verwendet wird, der in Benutzeroberflächen der Produktsoftware fest codiert ist, auf RFP-Dokumentation basiert oder von einem genannten Drittanbieterprodukt verwendet wird. Hier erfahren Sie mehr darüber, wie Cisco inklusive Sprache verwendet.
Informationen zu dieser Übersetzung
Cisco hat dieses Dokument maschinell übersetzen und von einem menschlichen Übersetzer editieren und korrigieren lassen, um unseren Benutzern auf der ganzen Welt Support-Inhalte in ihrer eigenen Sprache zu bieten. Bitte beachten Sie, dass selbst die beste maschinelle Übersetzung nicht so genau ist wie eine von einem professionellen Übersetzer angefertigte. Cisco Systems, Inc. übernimmt keine Haftung für die Richtigkeit dieser Übersetzungen und empfiehlt, immer das englische Originaldokument (siehe bereitgestellter Link) heranzuziehen.
Inhalt
Einleitung
Dieses Dokument beschreibt die Fehlerbehebung bei Problemen mit hoher CPU-Auslastung auf einem Router der Serie ASR 1000.
Voraussetzung
Anforderungen
Cisco empfiehlt, dass Sie mit der ASR 1000-Architektur vertraut sind, um dieses Dokument zu interpretieren und zu verwenden.
Beschreibung
Eine hohe CPU-Auslastung auf einem Cisco Router kann als die Bedingung definiert werden, bei der die CPU-Auslastung auf dem Router über der normalen Auslastung liegt. In einigen Szenarien wird eine erhöhte CPU-Auslastung erwartet, in anderen Szenarien kann dies auf ein Problem hinweisen. Eine vorübergehende hohe CPU-Auslastung auf dem Router aufgrund von Netzwerk- oder Konfigurationsänderungen kann ignoriert werden und ist ein erwartetes Verhalten.
Ein Router, bei dem die CPU über längere Zeiträume ohne Änderungen im Netzwerk oder in der Konfiguration stark ausgelastet ist, ist jedoch ungewöhnlich und muss analysiert werden. Daher kann die CPU bei Überlastung nicht alle anderen Prozesse aktiv bedienen, was zu einer langsamen Befehlszeile, einer Latenz auf der Kontrollebene, Paketverlusten und dem Ausfall von Services führt.
Die Ursachen für eine hohe CPU-Auslastung sind:
- Kontrollebenen-CPU empfängt zu viel Datenverkehr
- Ein Prozess, der sich unerwartet verhält und zu einer Überlastung der CPU führt
- Der Datenebenenprozessor ist überlastet/überbelegt.
- Zu viele Prozessorunterbrechungen
Eine hohe CPU ist nicht immer ein Problem mit Routern der Serie ASR 1000, da die CPU-Auslastung des Routers direkt proportional zur Auslastung des Routers ist. Wenn sich beispielsweise das Netzwerk ändert, führt dies zu einem großen Datenverkehrsvolumen auf der Kontrollebene, da das Netzwerk wieder konvergiert. Aus diesem Grund müssen wir die Ursache der CPU-Überlastung ermitteln, um festzustellen, ob ein erwartetes Verhalten vorliegt oder ein Problem vorliegt.
Das folgende Diagramm zeigt einen schrittweisen Prozess zur Fehlerbehebung bei Problemen mit hoher CPU:
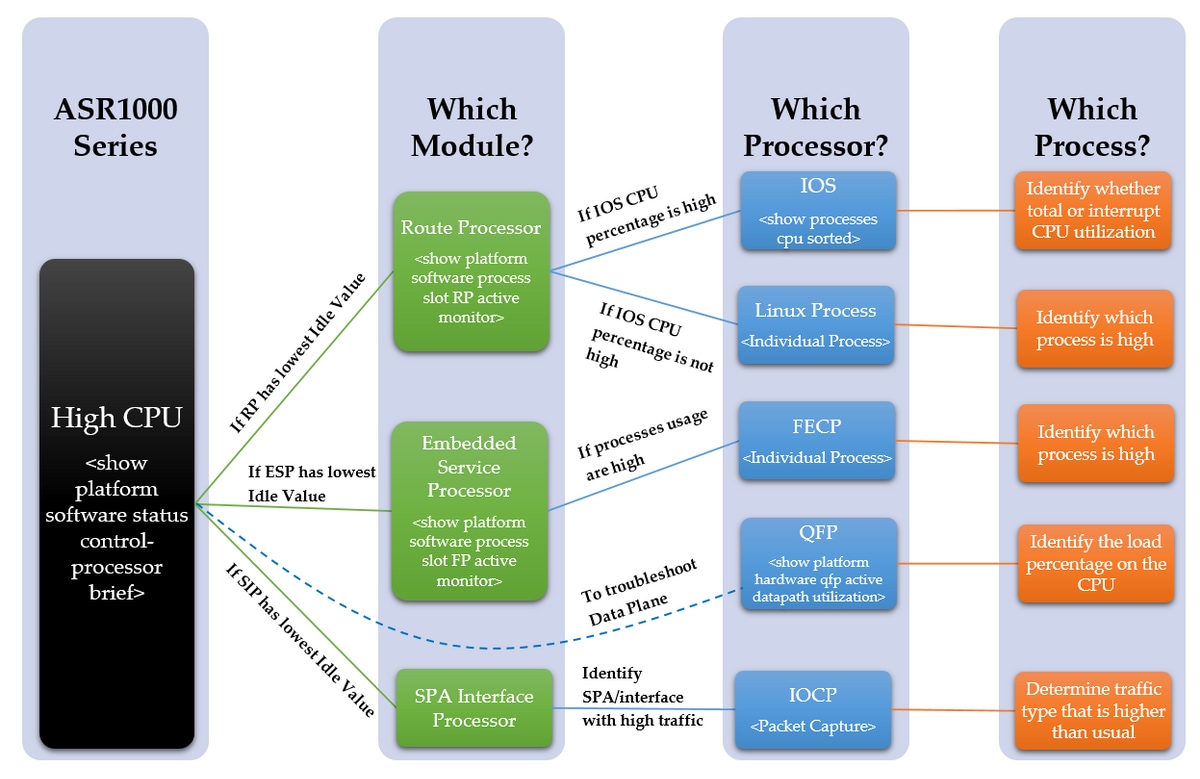
Schritte zur Fehlerbehebung
Schritt 1 - Identifizieren des Moduls mit hoher CPU
Der ASR1000 verfügt über verschiedene CPUs in den verschiedenen Modulen. Aus diesem Grund müssen wir uns ansehen, welches Modul mehr als normal verwendet wird. Dies ergibt sich aus dem Idle-Wert, da die CPU-Auslastung dieses Moduls umso höher ist, je niedriger der Idle-Wert ist. Diese verschiedenen CPUs spiegeln die Kontrollebene der Module wider.
Stellen Sie fest, für welches Modul im Gerät eine hohe CPU-Auslastung festgestellt wird. Ist es der RP, ESP oder SIP mit dem folgenden Befehl?
show platform software status control-prozessor brief
In der folgenden Ausgabe finden Sie die markierte Spalte.
Wenn der RP einen niedrigen Leerlaufwert aufweist, fahren Sie mit Schritt 2 Punkt 1 fort.
Wenn der Leerlaufwert des ESP niedrig ist, fahren Sie mit Schritt 3, Punkt 2, fort.
Wenn das SIP einen niedrigen Leerlaufwert aufweist, fahren Sie mit Schritt 4, Punkt 3, fort.
Router#show platform software status control-processor brief
Durchschnittswert für Auslastung
Steckplatzstatus 1-min 5-min 15-min
RP0 Gesund 0,00 0,02 0,00
ESP0 Gesund 0,01 0,02 0,00
SIP0 Gesund 0,00 0,01 0,00
Speicher (kB)
Steckplatzstatus gesamt genutzt (PCT) frei (PCT) aktiviert (PCT)
RP0 Gesund 2009376 1879196 (94%) 130180 ( 6%) 1432748 (71%)
ESP0 Gesund 2009400 692100 (34 %) 1317300 (66 %) 472536 (24 %)
SIP0 Gesund 471804 284424 (60 %) 187380 (40 %) 193148 (41 %)
CPU-Auslastung
Steckplatz CPU Benutzersystem Nice Idle IRQ SIRQ IOwait
UVP0 0 2,59 2,49 0,00 94,80 0,00 0,09 0,00
ESP0 0 2,30 17,90 0,00 79,80 0,00 0,00 0,00
SIP0 0 1,29 4,19 0,00 94,41 0,09 0,00 0,00
Wenn alle Leerlaufwerte relativ hoch sind, handelt es sich möglicherweise nicht um ein Problem auf der Kontrollebene. Zur Fehlerbehebung auf Datenebene muss der QFP des ESP beachtet werden. Die Symptome einer "hohen CPU" können aufgrund eines überlasteten QFP weiterhin beobachtet werden, was nicht zu einer hohen CPU auf den Prozessoren der Steuerungsebene führt. Fahren Sie mit SCHRITT 6 fort.
Schritt 2 - Analysieren des Moduls
- Routingprozessor
Mit dem folgenden Befehl können Sie im RP bestätigen, welcher Prozessor eine hohe CPU-Auslastung aufweist. Ist es der Linux-Prozess oder das IOS?
show plattform software prozess slot RP active monitor
Wenn der prozentuale Anteil der IOS-CPU hoch ist (linux_iosd-imag), ist dies der RP IOS. Fahren Sie mit SCHRITT 3 fort
Wenn der CPU-Prozentsatz anderer Prozesse hoch ist, handelt es sich wahrscheinlich um den Linux-Prozess. Fahren Sie mit SCHRITT 4 fort
- Integrierter Serviceprozessor
Bestätigen Sie im ESP, ob der Prozessor auf der Steuerungsebene eine hohe CPU-Auslastung aufweist. Ist es der FECP?
Plattformsoftware-Prozess, Steckplatz FP, aktiver Monitor
Bei hohen Prozessen als FECP fahren Sie mit SCHRITT 5 fort.
Handelt es sich nicht um den FECP, handelt es sich nicht um ein Problem im Zusammenhang mit den Kontrollebenenprozessen innerhalb des ESP. Wenn weiterhin Symptome wie Netzwerklatenz oder Warteschlangenverluste auftreten, muss die Datenebene möglicherweise auf Überlastung überprüft werden. Fahren Sie mit SCHRITT 6 fort
- SPA-Schnittstellenprozessor
Wenn festgestellt wird, dass das SIP eine hohe CPU-Auslastung aufweist, weist der IOCP eine hohe CPU-Auslastung auf. Bestimmen Sie, bei welchen Prozessen innerhalb des IOCP eine hohe CPU-Auslastung festgestellt wird.
Führen Sie eine Paketerfassung durch, und identifizieren Sie, welcher Datenverkehr höher als üblich ist und welche Prozesse diesem Datenverkehr zugeordnet sind. Fahren Sie mit SCHRITT 7 fort.
Schritt 3 - IOS-Prozesse
In der folgenden Ausgabe ist der erste Prozentsatz die Gesamt-CPU-Auslastung und der zweite Prozentsatz die Interrupt-CPU-Auslastung, d. h. die CPU-Auslastung, die zur Verarbeitung gelochter Pakete verwendet wird.
Wenn der Interrupt-Prozentsatz hoch ist, bedeutet dies, dass ein großer Teil des Datenverkehrs an den RP gesendet wird (dies kann mit dem Befehl show platform software infrastructure punt bestätigt werden)
Wenn der Interrupt-Prozentsatz niedrig ist, die CPU jedoch insgesamt hoch, dann gibt es einen oder mehrere Prozesse, die die CPU über einen längeren Zeitraum nutzen.
Mit dem folgenden Befehl können Sie im IOS bestätigen, bei welchen Prozessen eine hohe CPU-Auslastung festgestellt wird.
show prozesse cpu sortiert
Identifizieren Sie den hohen Prozentsatz (CPU gesamt oder Interrupt-CPU), und identifizieren Sie dann bei Bedarf die einzelnen Prozesse/Prozesse. Fahren Sie mit SCHRITT 7 fort
Router#show-Prozesse CPU-sortiert
CPU-Auslastung für fünf Sekunden: 0 %/0 %; eine Minute: 1%; fünf Minuten: 1%
PID-Laufzeit(ms) Aufgerufene Sekunden 5Sec 1Min 5Min TTY-Prozess
PID-Laufzeit(ms) Aufgerufene Sekunden 5Sec 1Min 5Min TTY-Prozess
188 8143 434758 18 0,15 % 0,18 % 0,19 % 0 Ethernet Msec Ti
515 380 7050 53 0,07 % 0,00 % 0,00 % 0 SBC-Hauptprozess
3 2154 215 10018 0,07% 0,00% 0,19% 0 EXEC
380 1783 55002 32 0,07% 0,06% 0,06% 0 MMA DB TIMER
63 3132 11143 281 0,07% 0,07% 0,07% 0 IOSD IPC-Aufgabe
5 1 2 500 0,00 % 0,00 % 0,00 % 0 IPC ISSU-Dispatch
6 19 12 1583 0,00% 0,00% 0,00% 0 RF Slave Main Th
8 0 1 0 0,00% 0,00% 0,00% 0 RO Timer benachrichtigen
7 0 1 0,00 % 0,00 % 0,00 % 0 EDDRI_MAIN
10 6 75 80 0,00% 0,00% 0,00% 0 Pool Manager
9 5671 538 10540 0,00% 0,14% 0,12% 0 Halden überprüfen
Schritt 4 - Linux-Prozesse
Wenn festgestellt wird, dass das IOS die CPU überlastet hat, müssen wir die CPU-Auslastung für den einzelnen Linux-Prozess beobachten. Diese Prozesse sind die anderen Prozesse, die auf der Seite show platform software process slot RP active monitor aufgeführt sind. Identifizieren Sie die Prozesse, bei denen eine hohe CPU-Auslastung festgestellt wird, und fahren Sie dann mit SCHRITT 7 fort.
Schritt 5 - FECP-Prozesse
Wenn ein Prozess oder mehrere Prozesse zu hoch sind, gehen Sie wie in SCHRITT 7 vor, um die Prozesse innerhalb des FECP zu bestimmen, die für die hohe CPU-Auslastung verantwortlich sind.
Schritt 6 - QFP-Nutzung
Der Quantum Flow Processor ist der weiterleitende ASIC. Zur Ermittlung der Auslastung der Forwarding-Engine kann der QFP überwacht werden. Der folgende Befehl listet die Eingangs- und Ausgangspakete (Priorität und Nicht-Priorität) in Paketen pro Sekunde und Bits pro Sekunde auf. In der letzten Zeile wird die gesamte CPU-Last aufgrund der Paketweiterleitung in Prozent angezeigt.
show plattform hardware qfp aktive datapath auslastung
Ermitteln Sie, ob die Ein- oder Ausgabe hoch ist, und zeigen Sie die Prozesslast an. Fahren Sie dann mit SCHRITT 7 fort.
Router#Plattformhardware anzeigen QFP Aktive Datenpfadnutzung
CPP 0: Subdev 0 5 Sek 1 Min 5 Min 60 Min
Eingabe: Priorität (pps) 0 0 0 0
(bit/s) 208 176 176 176
Keine Priorität 0 2 2 2
(bit/s) 64 784 784 784
Insgesamt (pps) 0 2 2 2
(bit/s) 272 960 960 960
Output: Priorität (pps) 0 0 0 0
(bit/s) 192 160 160 160
Nicht-Priorität (pps) 0 1 1 1
(bit/s) 0 6488 6496 6488
Gesamt (pps) 0 1 1 1
(bit/s) 192 6648 6656 6648
Verarbeitung: Last (pct) 0 0 0 0
Schritt 7 - Bestimmen der Ursache und Identifizieren der Korrektur
Wenn der Prozess bzw. die Prozesse, bei denen eine Überlastung der CPU festgestellt wird, erkannt werden, kann bzw. können deutlich gemacht werden, warum eine hohe CPU-Auslastung vorliegt. Recherchieren Sie zum Fortfahren die Funktionen, die durch den identifizierten Prozess ausgeführt wurden. Dies wird dazu beitragen, einen Aktionsplan zur Lösung des Problems zu erstellen. Beispiel: Wenn der Prozess für ein bestimmtes Protokoll verantwortlich ist, können Sie die Konfiguration für dieses Protokoll überprüfen.
Wenn weiterhin CPU-bezogene Probleme auftreten, wird empfohlen, sich an das TAC zu wenden, damit Ihnen ein Techniker bei der weiteren Fehlerbehebung helfen kann. Die oben genannten Schritte zur Fehlerbehebung helfen dem Techniker, das Problem effizienter zu isolieren.
Beispiel zur Fehlerbehebung
In diesem Beispiel werden wir den Fehlerbehebungsprozess durchlaufen und versuchen, eine mögliche Ursache für die hohe CPU des Routers zu ermitteln. Um zu beginnen, bestimmen Sie, welches Modul beobachtet wird, um die hohe CPU zu erleben, haben wir die folgende Ausgabe:
Router#show platform software status control-processor brief
Durchschnittswert für Auslastung
Steckplatzstatus 1-min 5-min 15-min
RP0 Gesund 0,66 0,15 0,05
ESP0 Gesund 0,00 0,00 0,00
SIP0 Gesund 0,00 0,00 0,00
Speicher (kB)
Steckplatzstatus gesamt genutzt (PCT) frei (PCT) aktiviert (PCT)
RP0 Gesund 2009376 1879196 (94%) 130180 ( 6%) 1432756 (71%)
ESP0 Gesund 2009400 692472 (34 %) 1316928 (66 %) 472668 (24 %)
SIP0 Gesund 471804 284556 (60 %) 187248 (40 %) 193148 (41 %)
CPU-Auslastung
Steckplatz CPU Benutzersystem Nice Idle IRQ SIRQ IOwait
UVP0 0 57,11 14,42 0,00 0,00 28,25 0,19 0,00
ESP0 0 2,10 17,91 0,00 79,97 0,00 0,00 0,00
SIP0 0 1,20 6,00 0,00 92,80 0,00 0,00 0,00
Da die Leerlaufmenge innerhalb des RP0 sehr niedrig ist, deutet dies auf ein hohes CPU-Problem innerhalb des Routingprozessors hin. Um eine weitere Fehlerbehebung durchzuführen, werden wir daher feststellen, für welchen Prozessor im RP eine hohe CPU-Auslastung festgestellt wird.
Router#show-Prozesse CPU-sortiert
CPU-Auslastung für fünf Sekunden: 84 %/36 %; eine Minute: 34%; fünf Minuten: 9%
PID-Laufzeit(ms) Aufgerufene Sekunden 5Sec 1Min 5Min TTY-Prozess
107 303230 50749 5975 46,69 % 18,12 % 4,45 % 0 IOSXE-RP Punt SE
63 105617 540091 195 0,23% 0,10% 0,08% 0 IOSD IPC Task
159 74792 2645991 28 0,15% 0,06% 0,06% 0 VRRS Hauptgewinde
116 53685 169683 316 0,15% 0,05% 0,01% 0 pro Sekunde Jobs
9 305547 26511 11525 0,15% 0,28% 0,16% 0 Halden überprüfen
188 362507 20979154 17 0,15% 0,15% 0,19% 0 Ethernet Msec Ti
3 147 186 790 0,07 % 0,08 % 0,02 % 0 EXEC
2 32126 33935 946 0,07% 0,03% 0,00% 0 Load Meter
446 416 33932 12 0,07 % 0,00 % 0,00 % 0 VDC-Prozess
164 59945 5261819 11 0,07% 0,04% 0,02% 0 IP ARP Alter
43 1703 16969 100 0,07% 0,00% 0,00% 0 IPC Keep Alive M
Aus dieser Ausgabe lässt sich beobachten, dass der Gesamt-CPU-Prozentsatz und der Interrupt-Prozentsatz höher sind als erwartet. Der oberste Prozess, der die CPU verwendet, ist der "IOSXE-RP Punt Se", der den Datenverkehr für die RP-CPU verarbeitet. Daher können wir diesen Datenverkehr, der an den RP gesendet wird, genauer untersuchen.
Router#show platform software infrastructure punt
Interne Statistiken der LSMPI-Schnittstelle:
enabled=0, disabled=0, throttled=0, unthrotted=0, state is ready
Eingabepuffer = 90100722
Ausgabepuffer = 100439
rxdone count = 90100722
txdone count = 100436
Rx keine Partitionstypanzahl = 0
Tx no particetype count = 0
Txbuf von Schattenzählung = 0
Kein Anfang des Pakets = 0
Kein Ende des Pakets = 0
Punt-Drop-Statistiken:
Fehlerhafte Version 0
Ungültiger Typ 0
Funktionsheader 0 vorhanden
Plattform-Header 0 vorhanden
Feature-Header fehlt 0
Häufige Header-Nichtübereinstimmung 0
Schlechte Gesamtlänge 0
Länge des ungültigen Pakets 0
Fehlerhafter Netzwerk-Offset 0
Header 0 nicht stempeln
Unbekannter Verbindungstyp 0
Kein Widder 1
Schlechter ESS-Feature-Header 0
Keine ESS-Funktion 0
Keine SSL VPN-Funktion 0
Punt für US-Typ unbekannt 0
Punt-Ursache außerhalb des Bereichs 0
IOSXE-RP-Punt-Paket verursacht:
6221026 Layer-2-Steuerungs- und Legacy-Pakete
147 ARP-Anforderungs- oder -Antwortpakete
27801234 For-us-Datenpakete
84426 RP<->QFP-Keepalive-Pakete
6 Glean-Adjacency-Pakete
1647 Kontrollpakete für Benutzer
FOR_US Control - IPv4-Protokollstatistiken:
1647 OSPF-Pakete
Pakethistogramm (500 Bytes/bin), durchschnittliche Größe in 92, von 56:
Anzahl eingehender Pakete (Pak-Size)
Mehr als 0: 90097805 98790
Über 500: 0 7
Aus dieser Ausgabe können wir sehen, gibt es eine große Anzahl von Paketen in der "Für-uns-Datenpakete", die den Verkehr in Richtung des Routers gerichtet zeigt, wurde dieser Zähler von der Beobachtung des Befehls mehrmals über mehrere Minuten erhöht worden. Dies bestätigt, dass die CPU durch einen großen Anteil an blockiertem Datenverkehr überlastet ist, bei dem es sich häufig um Steuerungsebenen-Datenverkehr handelt. Der Datenverkehr auf der Kontrollebene kann ARP, SSH, SNMP, Routen-Updates (BGP, EIGRP, OSPF) usw. umfassen. Anhand dieser Informationen können wir die potenzielle Ursache für die hohe CPU identifizieren, und dies hilft bei der Fehlerbehebung nach der Ursache. Beispielsweise könnte eine Paketerfassung oder eine Überwachung des unterschiedlichen Datenverkehrs implementiert werden, um den genauen Datenverkehr zu erkennen, der an den RP gesendet wird. Auf diese Weise könnte die Ursache identifiziert und behoben werden, um ein ähnliches Problem in Zukunft zu vermeiden.
Wenn die Paketerfassung abgeschlossen ist, sind einige Beispiele für potenziellen Punktverkehr:
- ARP: Dies kann auf eine zu hohe Anzahl von ARP-Anforderungen zurückzuführen sein, die auftreten, wenn mehrere IP-Adressen ARP-Anforderungen durch die Konfiguration einer IP-Route an eine Broadcast-Schnittstelle senden. Dies kann auch auf geleerte Einträge aus der ARP-Tabelle zurückzuführen sein und muss basierend auf den veralteten MAC-Adresseinträgen oder den Schnittstellen für das Hoch-/Herunterfahren neu abgerufen werden.
- SSH: Dies kann aufgrund eines großen Befehls show (show tech-support) oder wenn viele Debug-Befehle aktiviert sind, eine hohe CPU-Auslastung verursachen, wodurch viele CLIs über die SSH-Sitzung gesendet werden müssen.
- SNMP: Dies kann auf den SNMP-Agenten zurückzuführen sein, der eine Anforderung über einen langen Zeitraum verarbeitet und dadurch die hohe CPU verursacht. Häufig sind zwei mögliche Ursachen abgefragte MIBs oder vom NMS abgefragte Routing- und/oder ARP-Tabellen.
- Routen-Updates: Häufig sind zahlreiche Routen-Updates auf eine erneute Netzwerkkonvergenz oder Link-Flaps zurückzuführen. Dies kann auf Routen hinweisen, die innerhalb des Netzwerks ausfallen, oder auf ganze Geräte, die ausfallen und das Netzwerk zwingen, die besten Routen zu konvergieren und neu zu berechnen, je nachdem, welches Routing-Protokoll verwendet wird.
Dies zeigt, wie die Ursache der hohen CPU durch Identifizierung isoliert werden kann, wenn sie auf eine einzelne Prozessebene zurückgeht. Von hier aus kann der einzelne Prozess oder das Protokoll isoliert analysiert werden, um festzustellen, ob es sich um ein Konfigurationsproblem, ein Softwareproblem, ein Netzwerkdesign oder eine beabsichtigte Vorgehensweise handelt.
Zusätzliche Befehle
Im Folgenden finden Sie eine Liste weiterer nützlicher Befehle, die Sie verwenden können, und die nach dem Prozessor sortiert sind, auf den sie sich beziehen:
Routingprozessor
- <Prozess-CPU-Verlauf anzeigen>
- Stellt ein Diagramm des CPU-Verlaufs der letzten 60 Sekunden, Minuten und 72 Stunden bereit
- <Prozess-ID anzeigen_>
- Detaillierte Informationen zu einzelnen Prozessspeicher- und CPU-Zuweisungen
- <show platform software infrastructure punt>
- Stellt Informationen zum gesamten Datenverkehr bereit, der an den RP gesendet wird.
- <Plattformsoftware-Statussteuerung-Prozessorbeschreibung anzeigen>
- Detaillierte Informationen zur Auslastung und zum Zustand der CPU sowie zu Arbeitsspeicher- und Modulstatistiken
- <show platform software process slot r0|r1 monitor>
- Details zu den verschiedenen Prozessen und ihren CPU- und Speicherzuweisungen auf dem ausgewählten Modul
- <Überwachung des Plattform-Softwareprozesses r0|r1>
- Bietet einen Live-Feed, der die Prozesse bei Verwendung der CPU aktualisiert
- Erfordert die Eingabe des Befehls "terminal terminal type" in den globalen Konfigurationsmodus, um ordnungsgemäß zu funktionieren
Integrierter Serviceprozessor
- <Prozessliste der Plattformsoftware für aktive Zusammenfassung anzeigen>
- Beschreibt eine Zusammenfassung aller auf der CPU ausgeführten Prozesse sowie die durchschnittliche Last.
- <show platform software process slot f0|f1 monitor>
- Details zu den verschiedenen Prozessen und ihren CPU- und Speicherzuweisungen auf dem ausgewählten Modul
- <Überwachung des Plattform-Softwareprozesses f0|f1>
- Bietet einen Live-Feed, der die Prozesse bei Verwendung der CPU aktualisiert
- Erfordert die Eingabe des Befehls "terminal terminal type" in den globalen Konfigurationsmodus, um ordnungsgemäß zu funktionieren
Beiträge von Cisco Ingenieuren
- Chris CourtelisCisco Systems
 Feedback
Cisco kontaktieren
- Eine Supportanfrage öffnen

- (Erfordert einen Cisco Servicevertrag)